Voir ce que fait ton agent
La démo marche. Super.
Puis un client tombe sur une réponse bizarre… et tu ne sais pas pourquoi.
Ce chapitre (esprit bonus du cours Agents HF) est le plus utile en vrai : regarder.
En une phrase
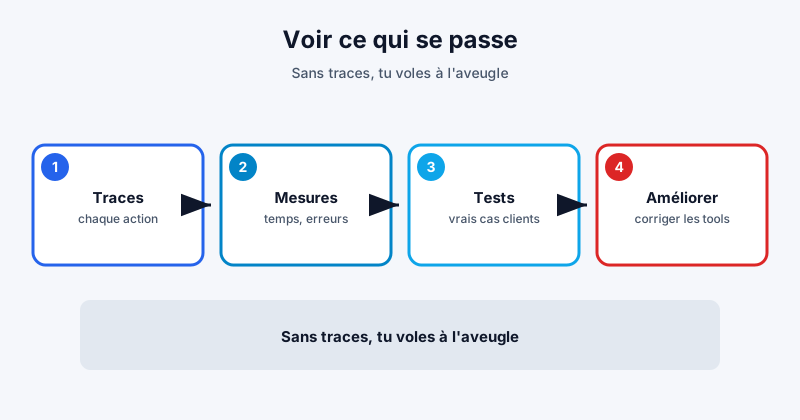
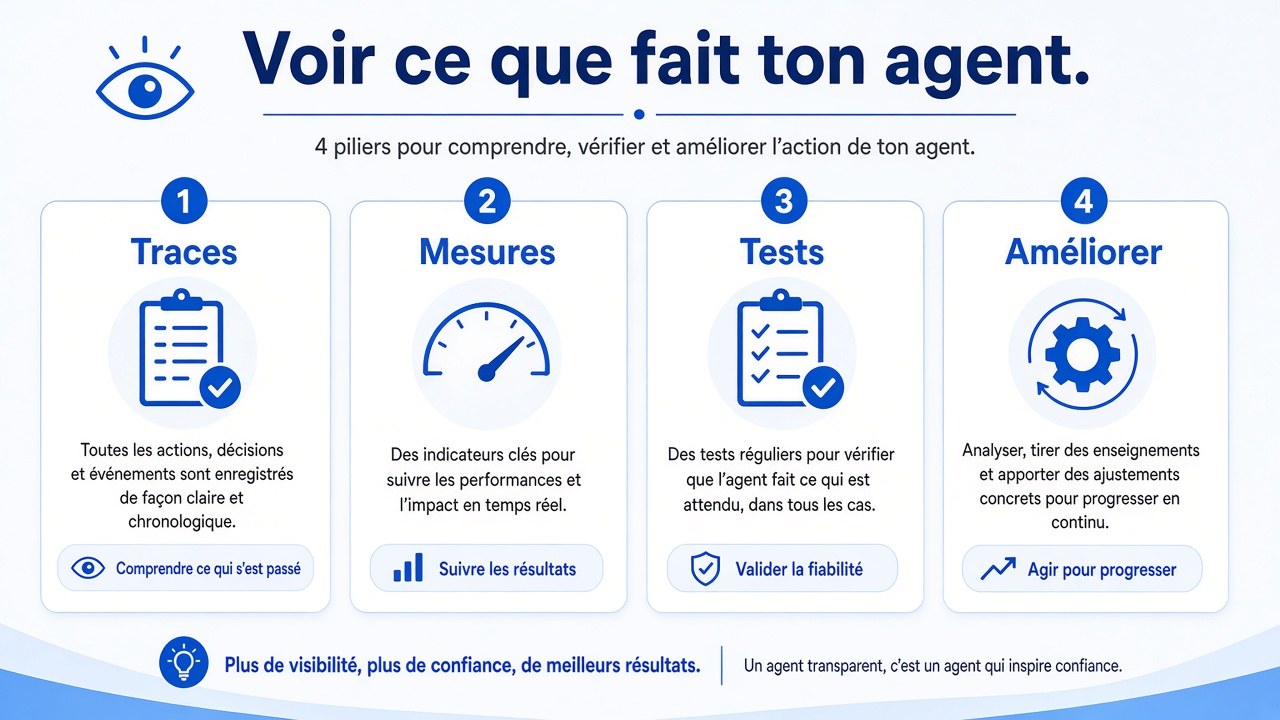
Tu enregistres ce que l'agent a fait (outils, résultats, réponse), tu mesures les échecs, tu corriges.
Quoi logger (minimum vital)
Pour chaque question :
- la question du client ;
- chaque outil appelé + arguments ;
- le résultat renvoyé (même en erreur) ;
- la réponse finale ;
- le nombre d'étapes ;
- le temps écoulé.
Sans ça, « il a halluciné » reste une légende de Slack.
Trois mesures simples
- Taux d'outils OK (succès / échec)
- Nombre d'étapes moyen
- « Je ne sais pas » propre quand l'info manque
Ajoute une revue humaine sur 10-20 messages par semaine. Cinq minutes, gros gain.
Comment améliorer sans tout casser
Regarde les échecs d'abord :
- description d'outil floue ?
- résultat illisible ?
- trop d'outils ?
- trop d'étapes autorisées ?
Corrige le contrat des outils avant de changer de modèle.
Mini routine hebdo
- Exporte 20 conversations.
- Classe : OK / douteux / faux.
- Pour les faux : ouvre la trace.
- Une correction (outil ou prompt), pas dix.
En résumé
Si tu ne vois pas la trace, tu ne pilotes pas.
Logs + petits tests + revue humaine = agent qui progresse.
Suite (bonus) : parfois le modèle se trompe trop souvent d'outil - on peut l'entraîner un peu pour ça.
Questions fréquentes (FAQ)
Quoi logger en priorité ?
Outil + arguments + résultat + réponse finale + nombre d'étapes.
L'éval auto suffit ?
Non seule. Garde un œil humain sur un échantillon.
Ça coûte cher ?
Moins cher qu'un client furieux. Commence léger.
Navigation dans la série
- Précédent : Chercher dans ta doc, puis répondre
- Suivant : Mieux appeler les outils (fine-tune)