Le Hub Hugging Face : modèles et datasets
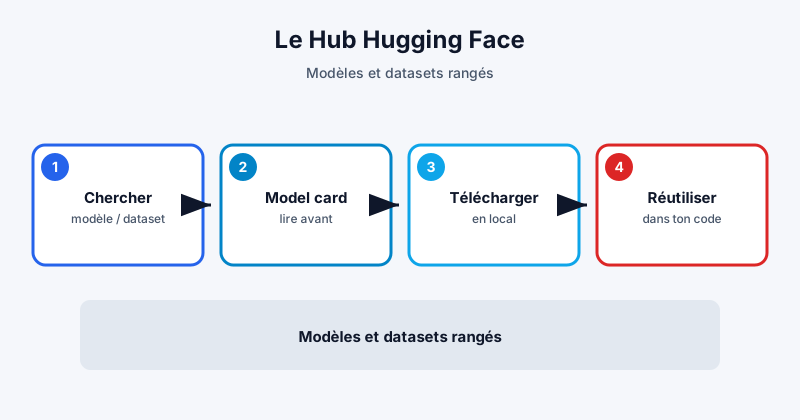
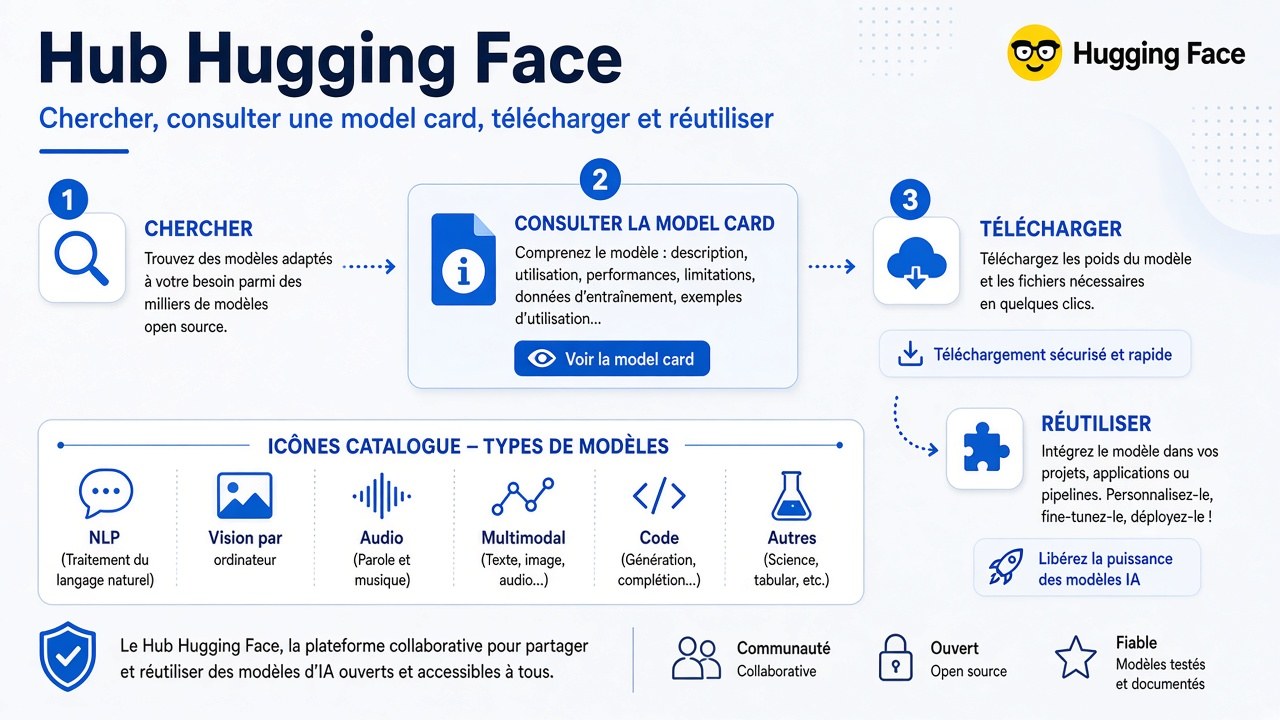
Le Hub, c'est le grand catalogue de Hugging Face : modèles, datasets, démos. Avant de coder trois heures, tu regardes ce qui existe déjà. Ça évite de réinventer la roue - et de télécharger un truc trop gros pour ta machine.
Cette série s'inspire du cours LLM Hugging Face. Ici, on reste en français simple, avec des exemples de terrain.
L'idée en une phrase
Cherche → lis la fiche → teste petit → intègre.
Comme au magasin : tu ne rachètes pas une machine sans regarder l'étiquette. Sur le Hub, l'étiquette, c'est la model card (la fiche du modèle).
C'est quoi, concrètement, le Hub ?
Imagine un rayon où chaque boîte a :
- un nom (ex. un modèle de classification) ;
- une tâche (classer, générer, traduire…) ;
- une taille (ça tient sur ton PC ?) ;
- une licence (tu as le droit de l'utiliser comment ?) ;
- parfois des exemples et des limites connues.
Tu peux filtrer par tâche, par langue, par popularité. Tu peux aussi chercher un dataset : un jeu d'exemples déjà rangé pour entraîner ou évaluer.
Pour un commerce du Grand Est, tu ne cherches pas « le modèle le plus hype ». Tu cherches celui qui parle correctement le français, qui matche ta tâche, et que tu peux tester sans te ruiner en temps machine.
Model card : lis avant de télécharger
Sur la page d'un modèle, regarde au minimum :
- la tâche (classification, génération, résumé…) ;
- la langue (français ? multilingue ?) ;
- la licence (usage commercial OK ou pas ?) ;
- les limites / biais signalés par les auteurs ;
- la taille (nombre de paramètres, poids en Go) ;
- les exemples : est-ce que ça ressemble à ton cas ?
Si la fiche est vide, confuse, ou trop marketing, méfiance. Une bonne model card, c'est un peu comme une fiche produit honnête : tu sais ce que tu achètes.
Mini check-list avant de cliquer « télécharger »
- Est-ce la bonne tâche ? (classer ≠ chatter)
- Est-ce la bonne langue ?
- Est-ce que ça rentre dans ma machine (ou mon budget cloud) ?
- Est-ce que la licence me convient ?
- Y a-t-il un exemple proche de mes textes métier ?
Si tu coches « non » trop souvent, passe au suivant. Le Hub est vaste : tu n'es pas coincé avec le premier résultat.
Datasets : même logique
Un dataset, c'est un lot d'exemples. Souvent : du texte + une étiquette (positif / négatif), ou une paire entrée / sortie (texte long → résumé).
Sur la fiche d'un dataset, regarde :
- d'où viennent les données ;
- la licence ;
- les colonnes (quelles infos dans chaque ligne) ;
- la qualité (doublons, erreurs, bruit) ;
- la langue et le domaine (avis resto ≠ mails B2B).
Un beau nom ne garantit rien. Un dataset « sentiment » entraîné sur des tweets anglais ne te sauvera pas pour des avis Google en français sur une boutique à Nancy.
Exemple terrain (Metz / Lorraine)
Tu veux classer les avis de ta boutique. Option A : coller un dataset public au feeling. Option B : partir d'un petit jeu à toi (même 150 à 300 avis bien labellisés) et, si besoin, compléter avec un dataset proche.
Souvent, B gagne. Qualité locale > volume lointain.
Comment chercher sans te perdre
Par tâche. Tu sais que tu classifies → filtre « text-classification ». Tu génères → génération / text-generation. Tu résumes → summarization.
Par langue. Ajoute « french » ou un modèle multilingue, puis teste avec tes phrases réelles.
Par taille. Sur un laptop moyen, commence petit. Un modèle léger qui marche à 85 % sur ton cas bat un monstre qui rame et invente.
Par downloads / likes ? Ça donne une piste, pas une vérité. Un modèle peu téléchargé mais bien documenté pour le français peut te servir mieux qu'un star anglophone.
Télécharger et réutiliser (esprit, pas le code)
Dans la pratique, tu vas :
- choisir un modèle (ou un dataset) ;
- le charger avec les libs Hugging Face (Transformers, Datasets) ;
- faire un test local sur 10-20 exemples ;
- seulement ensuite brancher ça dans un vrai process.
Tu n'as pas besoin de tout comprendre d'un coup. Le réflexe, c'est : lire → tester petit → décider.
Bon réflexe DanielCraft
Je ne colle pas un modèle inconnu en prod. Je teste sur tes textes (avis, mails, FAQ). Si ça se trompe trop, on change - ou on fine-tune plus tard.
Même idée pour un dataset : si les labels sont sales, le modèle apprend n'importe quoi. On nettoie d'abord. On accélère ensuite.
Publier (quand tu seras prêt)
Oui, tu peux publier ton modèle ou ton dataset sur le Hub. Mais fais-le proprement :
- une vraie fiche (tâche, langue, licence, limites) ;
- des exemples ;
- pas de données personnelles clients en clair.
C'est utile pour partager avec un collègue, un client technique, ou toi-même dans six mois.
En résumé
Le Hub accélère. La model card te protège. Un dataset propre te fait gagner des semaines.
Cherche. Lis. Teste petit. Puis intègre. Pas l'inverse.
Questions fréquentes (FAQ)
Tout est gratuit ?
Beaucoup de modèles et datasets sont ouverts. Mais lis la licence et les conditions d'usage. « Ouvert » ne veut pas toujours dire « usage commercial libre sans contrainte ».
Je peux publier mon modèle ?
Oui, quand tu es prêt - avec une vraie fiche, une licence claire, et sans données sensibles.
Comment savoir si un modèle parle français ?
Regarde la fiche (langue, exemples). Puis teste avec tes phrases. La card peut dire « multilingual » et quand même être faible sur ton jargon boutique.
Le modèle le plus téléchargé est le meilleur ?
Pas forcément. Popularité ≠ adaptation à ton métier. Mesure sur tes exemples.
Je dois tout télécharger d'un coup ?
Non. Commence par un petit modèle et un échantillon de données. Tu verras vite si la piste est bonne.
Navigation dans la série
- Précédent : Architectures
- Suivant : Tokenizers et datasets