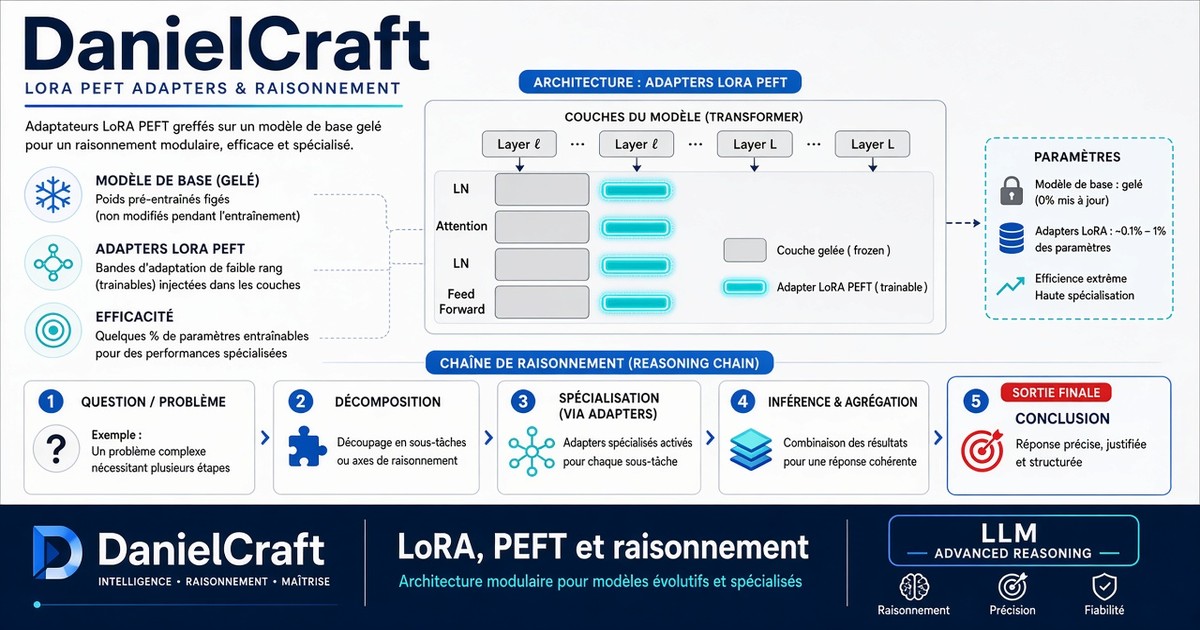
LoRA et raisonnement : adapter sans tout réécrire
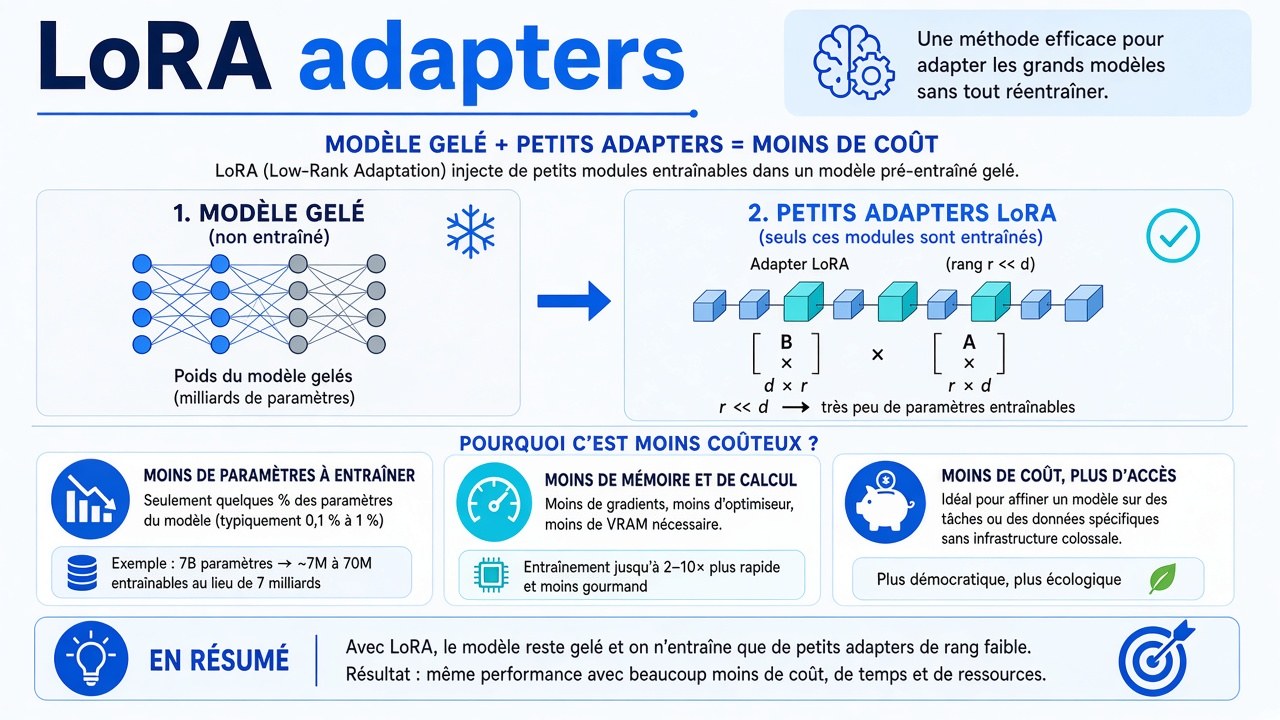
Fine-tuner tout un gros modèle coûte cher : mémoire, temps, argent. LoRA (et la famille PEFT) ajoute de petits adapters : tu adaptes sans tout réécrire.
PEFT, en français simple : techniques pour adapter un modèle en touchant seulement une petite partie des paramètres. LoRA est l'une des plus connues.
Cette série s'inspire du cours LLM Hugging Face. Ici, on ferme la boucle LLM - et on ouvre la porte vers les agents.
L'idée en une phrase
Base fixe + petites pièces apprises = spécialisation moins chère.
Comme une boutique qui garde le même local, mais change la vitrine selon la saison : tu n'abats pas les murs à chaque fois.
Pourquoi LoRA (en vrai)
- moins de mémoire : tu n'entraînes pas tous les poids ;
- entraînements plus courts : souvent plus abordable sur une machine raisonnable ;
- plusieurs adapters : un pour les avis, un pour les mails devis, sans dupliquer tout le modèle ;
- retour arrière facile : tu retires l'adapter, tu retrouves la base.
Tu gardes le modèle de base (souvent « gelé » : on ne le modifie pas en entier). Tu apprends de petites matrices (les adapters). Au moment d'utiliser, tu combines base + adapter.
Quand LoRA aide
- tu veux spécialiser un modèle de génération assez gros ;
- le fine-tuning complet est trop lourd pour ta machine ;
- tu as plusieurs métiers / tons (boutique A vs boutique B) ;
- tu itères souvent : changer un petit adapter coûte moins cher que tout réentraîner.
Exemple (Metz / Lorraine)
Tu as un modèle qui rédige des brouillons de réponse client. Pour la boutique chaussures, le ton est chaleureux. Pour l'atelier SAV, le ton est plus factuel. Deux adapters LoRA, même base. Tu charges celui qui correspond. Tu ne stockes pas deux monstrueux modèles complets.
Quand ce n'est pas magique
- si tu n'as aucune donnée propre, LoRA n'invente pas la qualité ;
- pour une petite classification, un fine-tuning classique sur un petit modèle peut suffire ;
- si le brief est flou, l'adapter apprend du flou ;
- LoRA réduit le coût, pas le besoin de valider les sorties.
Raisonnement / briefing : aussi important que la taille
Un modèle « qui raisonne mieux », ce n'est pas seulement plus de paramètres. C'est aussi :
- une consigne claire (quoi faire, quoi éviter, quel format) ;
- des exemples (few-shot : tu montres 2-3 cas avant de demander) ;
- des outils quand il faut une preuve (horaires, stock) - voir la série Agents ;
- une relecture humaine sur ce qui part chez le client.
Tu peux avoir LoRA + un mauvais brief = résultats moyens.
Tu peux avoir un modèle moyen + un brief carré + des outils = résultat pro.
Mini brief boutique
Mauvais : « Réponds au client. »
Meilleur : « Tu es l'assistant d'une boutique à Metz. Réponds poli, tutoiement, 5 lignes max. Si tu n'as pas l'horaire, dis que tu ne sais pas - n'invente pas. »
Le second guide. Le premier laisse inventer.
LoRA + démo + terrain
Enchaînement propre :
- données propres (article tokenizers) ;
- adapter LoRA (ou fine-tuning léger) ;
- démo Gradio pour faire tester ;
- feedback → enrichir les exemples ;
- si besoin d'outils réels (horaires, devis) → passer côté agents.
Le modèle adapté rédige. L'agent, lui, peut vérifier une info via un outil. Les deux se complètent.
Suite logique : les agents
Cette série LLM t'a donné : pipeline, architectures, Hub, tokens, fine-tuning, Gradio, LoRA.
La suite naturelle : un modèle qui n'écrit pas seulement, mais agit avec des outils et une boucle de vérification.
- Série : Agents IA Hugging Face
- Premier article : Agents IA : c'est quoi, au juste ?
Là, on parle cerveau + outils + boucle. Utile dès que tu veux des réponses ancrées dans tes règles métier.
En résumé
LoRA = fine-tuning malin : base fixe, petites pièces apprises.
Le briefing + la validation restent ton métier. Les outils (agents) complètent quand il faut une preuve. Inspiration pédagogique : cours LLM HF. Suite logique : les agents.
Questions fréquentes (FAQ)
LoRA remplace le fine-tuning classique ?
Souvent un excellent défaut pour les gros modèles. Pour un petit classifieur, le fine-tuning classique reste simple et efficace. Choisis selon la taille et le budget.
Je dois comprendre toutes les maths LoRA ?
Non pour démarrer. Retiens : petits adapters, base gelée, moins de coût. Les libs PEFT gèrent le détail.
Et après cette série ?
Les agents IA : outils + boucle. Commence par c'est quoi un agent.
Plusieurs adapters sur la même base ?
Oui, c'est un des intérêts. Un adapter par tâche ou par ton, tu charges celui qu'il te faut.
LoRA garantit zéro invention ?
Non. Ça spécialise. Pour coller à des faits (horaires, stock), branche des outils et garde une relecture.
Navigation dans la série
- Précédent : Gradio
- Série Agents : C'est quoi un agent ?
- Hub série agents : Agents IA Hugging Face