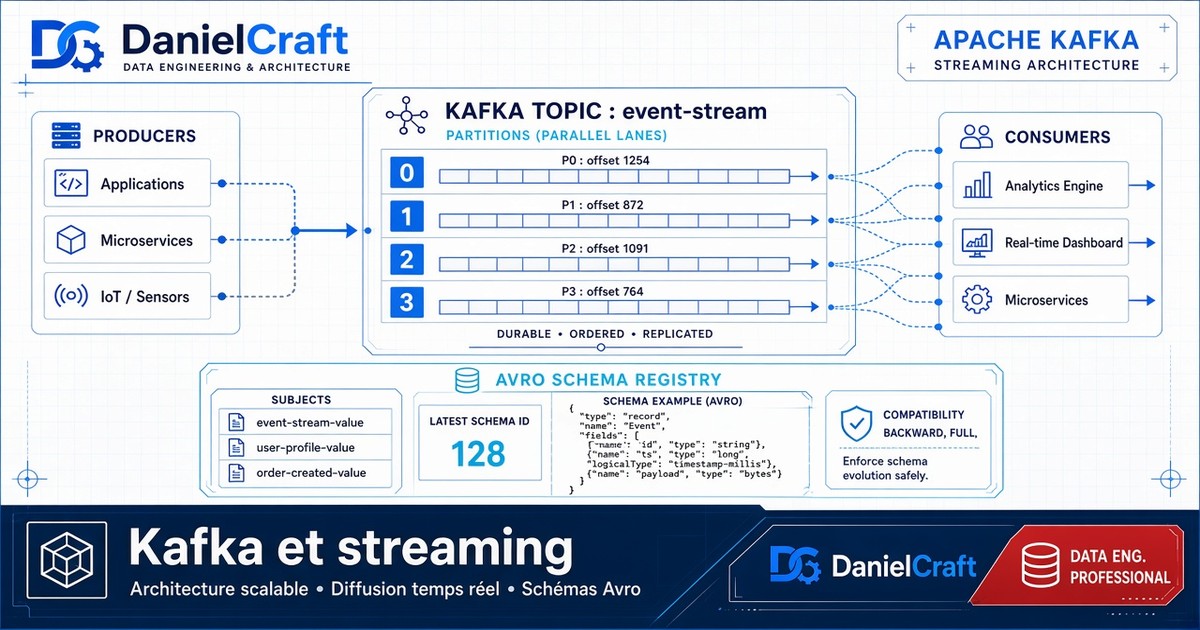
Kafka : événements en continu
Le batch tourne chaque nuit. Le streaming réagit aux événements au fil de l'eau : clic, commande, paiement, capteur… Kafka est un outil courant pour faire circuler ces événements entre systèmes. Puissant. Pas magique. Pas obligatoire pour une boutique qui veut juste le CA du matin.
Cette série s'inspire du Data Engineering Zoomcamp. On termine la carte mentale bout en bout - avec un rappel important dès maintenant.
L'idée en une phrase
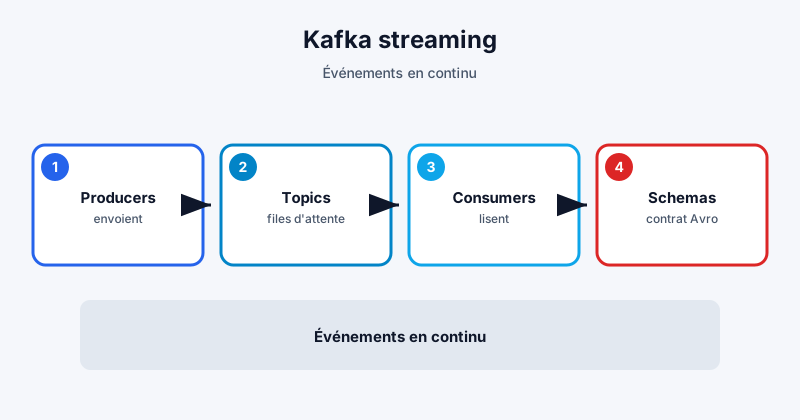
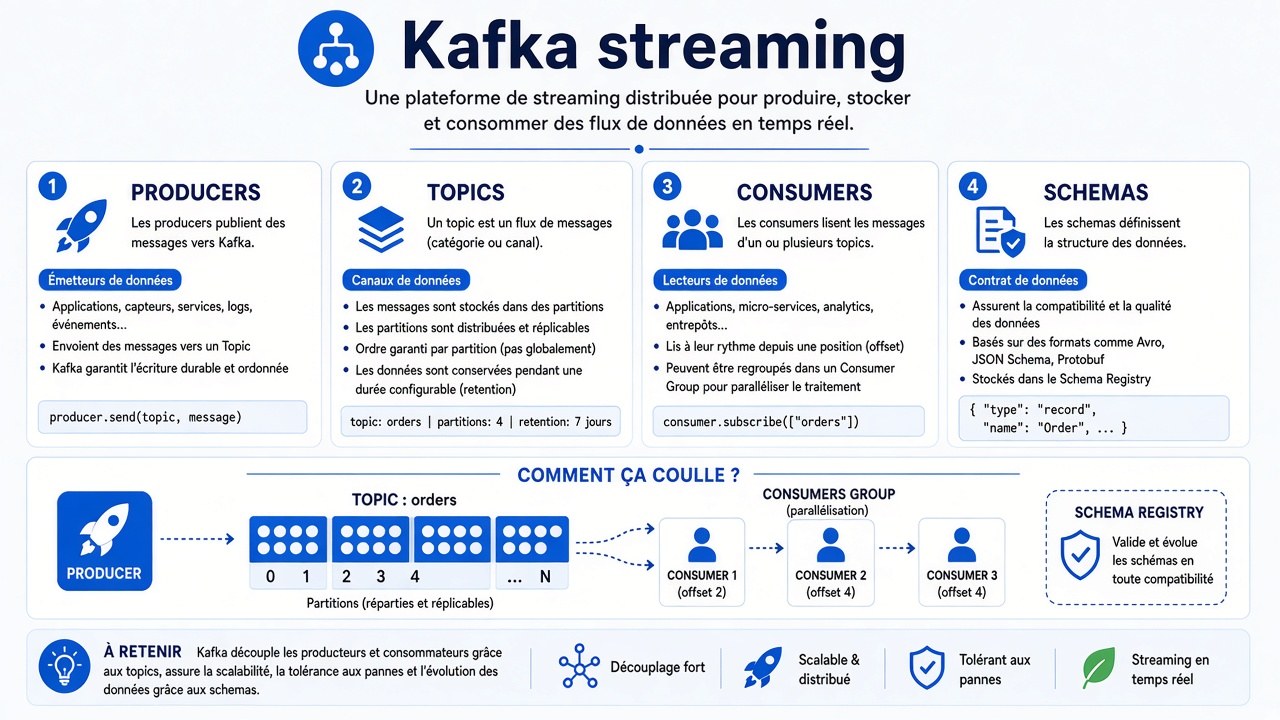
Quelqu'un publie → ça attend dans un topic → quelqu'un consomme.
D'abord : le batch suffit souvent
Avant Kafka, respire. Beaucoup de besoins « temps réel » en commerce sont en fait :
- « je veux le chiffre à l'ouverture » → un batch à 5 h suffit ;
- « je veux voir les ventes d'hier » → entrepôt + dbt ;
- « je ne veux plus d'Excel le lundi » → pipeline nocturne fiable.
Une boutique à Metz, un salon à Nancy, un atelier à Épinal : si un import horaire ou nocturne couvre le métier, ne force pas Kafka pour le CV. Maîtrise d'abord ingestion incrémentale, entrepôt en couches, orchestration, dbt. Le streaming vient quand le délai batch devient un vrai problème business (stock réservé en double, fraude, suivi live d'un flux critique…).
Garde cette phrase sous le coude : batch d'abord, Kafka ensuite - seulement si le besoin est réel.
Les 3 rôles (à retenir)
1. Producer
Envoie l'événement. Exemple : la caisse publie commande_creee avec l'id, le montant, le magasin.
2. Topic
Le canal / la file. Les événements s'y empilent dans l'ordre (par partition). Plusieurs consommateurs peuvent lire le même topic pour des usages différents (stock, analytics, alerte).
3. Consumer
Lit et agit : enrichir, écrire en base, alerter, pousser vers l'entrepôt. Il avance à son rythme. S'il est en retard, le topic garde l'historique un moment (selon config).
Image mentale : un couloir de messages robuste. Pas une base de données de reporting. Pas un remplacement de BigQuery.
Exemple commerce (Lorraine)
Sans streaming : chaque nuit, on charge les commandes. Le stock e-commerce se met à jour le matin. Ça va… jusqu'au jour du rush de Noël où deux clients réservent le dernier objet en vitrine virtuelle.
Avec événements (esprit Kafka) :
- producer : chaque réservation publie un event ;
- topic
reservations; - consumer stock : décrémente tout de suite ;
- un autre consumer : alimente un flux analytics (plus tard).
Là, le temps compte vraiment. Pour le panier moyen hebdo, en revanche, le batch nocturne reste parfait. N'utilise pas le même outil pour les deux besoins.
Schémas (Avro, JSON… )
Mettez-vous d'accord sur le format du message. Sinon le consumer casse le jour où un champ change de type (montant string vs number). Versionne le contrat. Annonce les breaking changes. Même esprit que pour une API de boutique : un contrat clair bat la surprise.
JSON suffit pour apprendre. En prod sérieuse, on voit souvent des schémas plus stricts. L'idée : pas de « on verra bien » sur le payload.
Ce que Kafka n'est pas
- Ce n'est pas une base analytique.
- Ce n'est pas un remplacement de dbt.
- Ce n'est pas gratuit en complexité (ops, monitoring, schémas, rejeu).
- Ce n'est pas le premier tuyau à poser pour une TPE.
Kafka (ou un bus d'événements managé) brille quand plusieurs systèmes doivent réagir au même fait, vite, sans se téléphoner en point à point fragile.
Quand s'en passer (rappel)
- un import horaire suffit au métier ;
- une seule destination pour les données ;
- l'équipe ne sait pas encore faire tourner un batch fiable ;
- tu veux surtout un dashboard du matin.
Dans ces cas : reviens aux articles 1 à 6. Spark (article 7) si le volume batch explose. Kafka seulement après.
La carte mentale de la série
- Pipeline bout en bout (tuyaux, pas seulement le graphique).
- Docker + Terraform (socle rejouable).
- Orchestration (planifier, retenter, alerter).
- Ingestion incrémentale.
- Entrepôt et couches.
- dbt (SQL testé).
- Spark si gros batch.
- Kafka si vrai besoin événementiel.
Tu as la carte. Pas besoin de tout déployer demain. Une source, une table propre, un schedule - ça reste le meilleur premier pas pour une boutique du Grand Est.
En résumé
Kafka = tuyau (quasi) temps réel pour les events. Puissant, mais seulement si le besoin est temps réel.
Le batch suffit souvent - maîtrise-le avant de monter un cluster de messages.
Inspiration : Zoomcamp DataTalks. Le texte de cette série est original ; le parcours, lui, est une boussole connue.
Questions fréquentes (FAQ)
Kafka = base de données ?
Non. C'est un journal / bus d'événements. L'analytique reste dans l'entrepôt.
Je commence par le streaming ?
Non. Maîtrise d'abord un pipeline batch simple. Le streaming sans bases solides, c'est de la complexité tôt.
Faut-il Kafka pour un dashboard ?
Presque jamais. Un job planifié + marts propres suffisent dans la majorité des commerces.
Un message perdu, ça arrive ?
Avec une bonne config et des consumers soignés, tu vises la fiabilité. Mais tu surveilles. Comme le reste du tuyau : observable ou danger.
Alternative plus simple ?
Parfois une file managée plus légère, ou même un webhook + table de file maison pour un seul flux. Kafka brille quand le volume d'events et le nombre de consommateurs montent.
Navigation dans la série
- Précédent : Spark