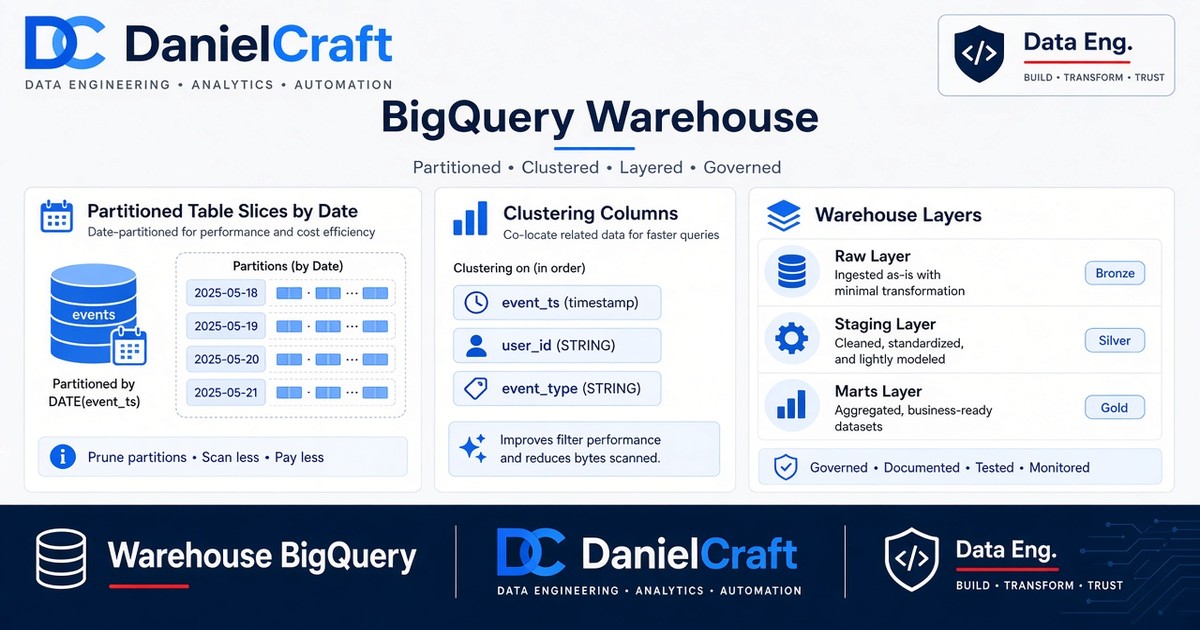
BigQuery : l'entrepôt pour analyser
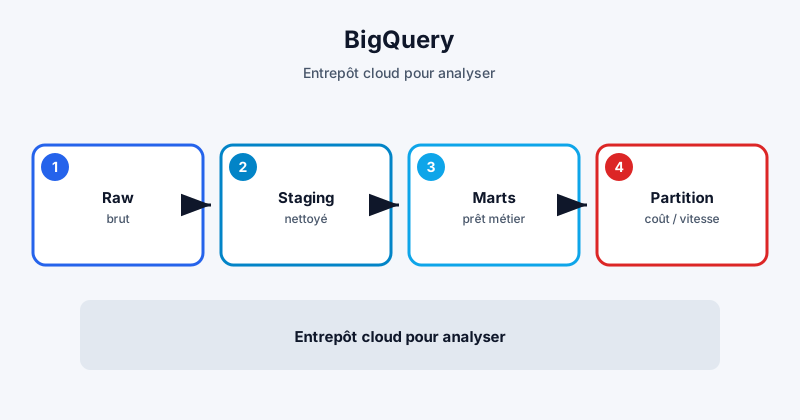
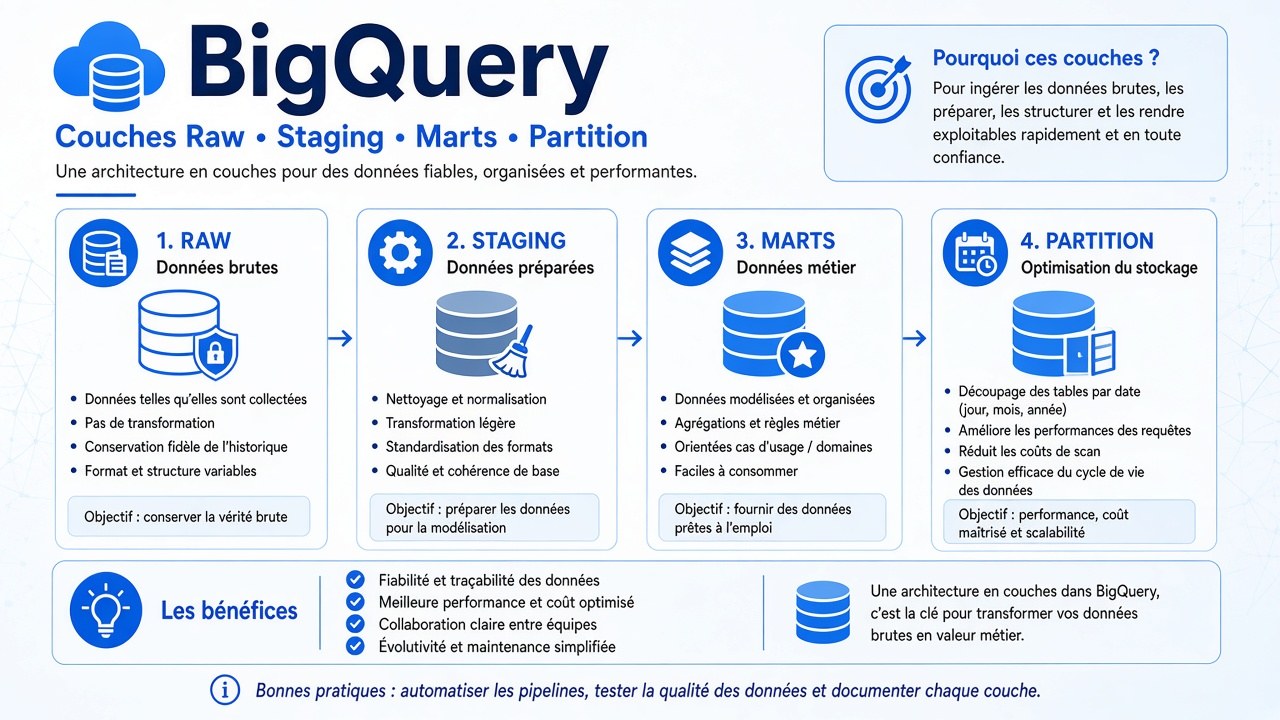
L'entrepôt, c'est le lieu où les données vivent pour être analysées. Pas la base qui sert la boutique en journée. Un endroit calme, rangé, pensé pour les requêtes et les dashboards. BigQuery est un exemple cloud courant dans les parcours type Zoomcamp. L'esprit des couches marche aussi ailleurs.
Cette série s'inspire du Data Engineering Zoomcamp. On reste en français simple : raw, staging, marts, coût, boutique.
L'idée en une phrase
Couches claires : brut, nettoyé, prêt métier.
Pourquoi un entrepôt (et pas « juste la base de prod ») ?
La base de la caisse sert à encaisser. Elle déteste les grosses requêtes du lundi matin (« panier moyen par magasin sur 18 mois »). L'entrepôt, lui, est fait pour ça. Tu copies (ou tu charges) les données utiles, tu les ranges, tu laisses le métier interroger sans freiner la boutique.
Exemple : une enseigne avec un point de vente à Metz et un autre à Nancy. Le gérant veut comparer panier moyen et taux de retour. Sur la prod, c'est risqué et lent. Sur l'entrepôt, c'est le job.
Les 3 couches (à retenir)
1. Raw (brut)
Tel quel, ou presque. Ce que l'ingestion a posé. Colonnes techniques OK (loaded_at). Peu de logique métier. Tu gardes la trace. Si la source ment, tu veux pouvoir le prouver.
2. Staging (nettoyé)
Types propres, dates cohérentes, jointures de base, noms stables. Tu enlèves le bruit évident. Tu ne construis pas encore « le chiffre officiel du panier moyen », mais tu prépares le terrain.
3. Marts (prêt métier)
Tables que le métier comprend : fct_commandes_jour, panier_moyen_semaine, promo_mirabelle_impact. C'est ce que le dashboard lit. Noms clairs. Une question = souvent une table (ou presque).
Un entrepôt sans couches, c'est un grenier. Avec couches, c'est une boutique rangée : le client trouve le rayon, toi tu sais où remettre le stock.
Partition et filtre (coût / vitesse)
Dans BigQuery (et ailleurs), interroger tout l'historique « parce que » coûte cher et lent. Tu partitionnes souvent par date. Tu filtres WHERE date_commande >= .... Tu ne scans pas 2019 pour une question sur hier.
Règle simple pour une boutique lorraine : la plupart des questions portent sur les 7, 30 ou 90 derniers jours. Construis tes tables et tes habitudes autour de ça. L'historique long existe - tu ne le balayes pas à chaque clic.
Qui écrit quoi ?
- Ingestion → raw
- Transforms SQL / dbt → staging et marts
- Métier / BI → lit surtout les marts
Si tout le monde écrit n'importe où, tu reviens au tableur partagé, version cloud. Pose des droits minimaux. La personne qui fait le dashboard n'a pas besoin d'écrire dans le raw.
Exemple concret (Metz)
Flux du matin :
- raw : commandes API de la nuit ;
- staging : types, dédoublonnage, fuseau Europe/Paris ;
- mart : table
ventes_jouravec panier moyen, nb commandes, CA.
Le gérant ouvre le dashboard. Il ne voit pas le JSON de l'API. Il voit trois colonnes utiles. C'est ça, un entrepôt qui sert.
Même esprit pour un artisan à Épinal qui suit les commandes web + le retrait en magasin : deux sources en raw, une mart « commandes unifiées » pour le suivi.
Ce que BigQuery n'est pas
Ce n'est pas obligatoire. Postgres dédié, Snowflake, autre warehouse : l'esprit couches reste.
Ce n'est pas un remplacement de ta base de caisse.
Ce n'est pas un endroit pour coller 40 tables « tmp_final_v3 » sans doc.
Choisis un outil. Apprends les couches. Le logo compte moins que le rangement.
Erreurs classiques
-
Une seule couche fourre-tout
Impossible de reconstruire. Sépare brut et métier. -
Requêtes sans filtre de date
Coût + lenteur. Habitue-toi au filtre. -
Noms obscurs
t_x2,data_new. Dans six mois, toi non plus tu ne sauras plus. -
Copier la prod telle quelle sans contrat
L'entrepôt a son modèle. Tu ne recopies pas le chaos - tu l'assumes au raw, tu le ranges ensuite.
Comment ça se branche sur la suite
dbt (prochain article) brille pour construire staging et marts en SQL versionné, avec tests. Spark arrive plus tard si le volume explose. Kafka, seulement si le temps réel est un vrai besoin. Pour beaucoup de commerces du Grand Est, raw + staging + marts en batch nocturne, c'est déjà le jackpot.
En résumé
Un entrepôt sans couches, c'est un grenier. Avec couches, c'est une boutique rangée.
Raw pour garder, staging pour nettoyer, marts pour décider.
Prochaine étape : transformer en SQL testé avec dbt.
Questions fréquentes (FAQ)
Obligé BigQuery ?
Non. L'esprit couches reste valable ailleurs. BigQuery est un bon exemple cloud, pas une religion.
Je peux tout faire en raw ?
Tu peux. Tu vas souffrir. Le métier mérite des tables lisibles.
Partition dès le jour 1 ?
Dès que tu as une date métier et un volume qui grossit, oui. Habitude pas chère, économie réelle plus tard.
Le dashboard lit quelle couche ?
Idéalement les marts. Si tu branches la viz sur le raw, tu vas expliquer le JSON à tout le monde - mauvais deal.
Et le coût ?
Filtre, partitionne, évite SELECT * sur l'historique. Mesure. Une boutique n'a pas le budget d'un scan planétaire chaque matin.