Série Data Engineering : pipeline de bout en bout
Des tuyaux data de bout en bout : Docker, orchestration, BigQuery, dbt, Spark, Kafka - en français simple, avec schémas. Inspiration Zoomcamp DataTalks.
Tutoriel
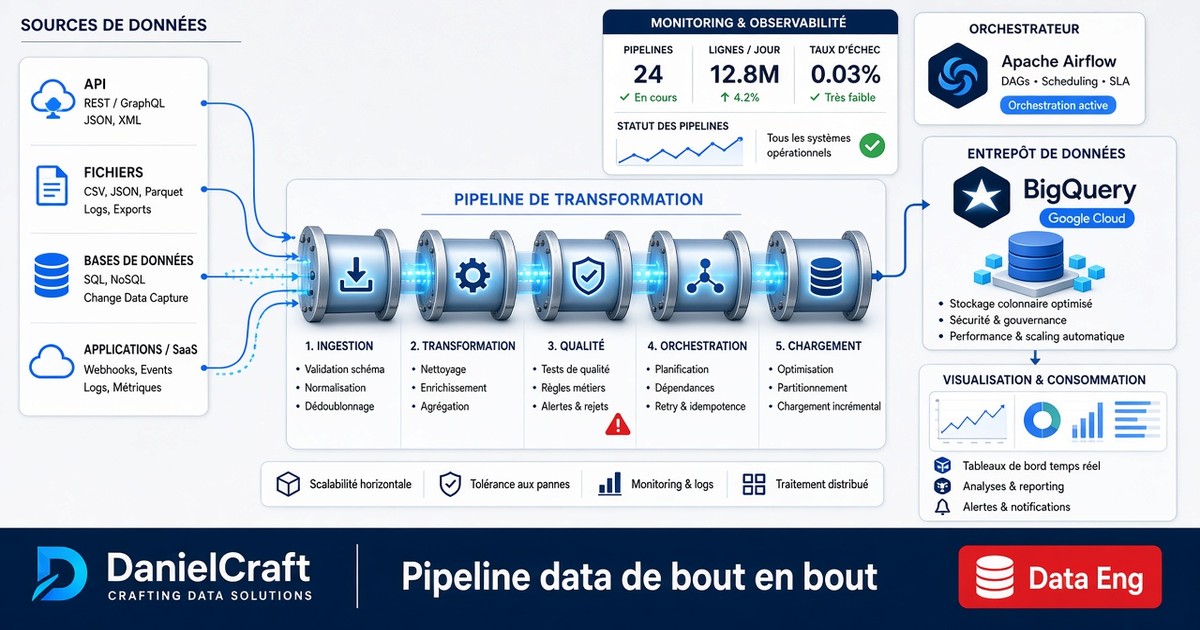
Data engineering : un pipeline de bout en bout
C'est quoi un data engineer, et comment relier sources, transform, entrepôt et dashboards sans jargon.
Lire l’article →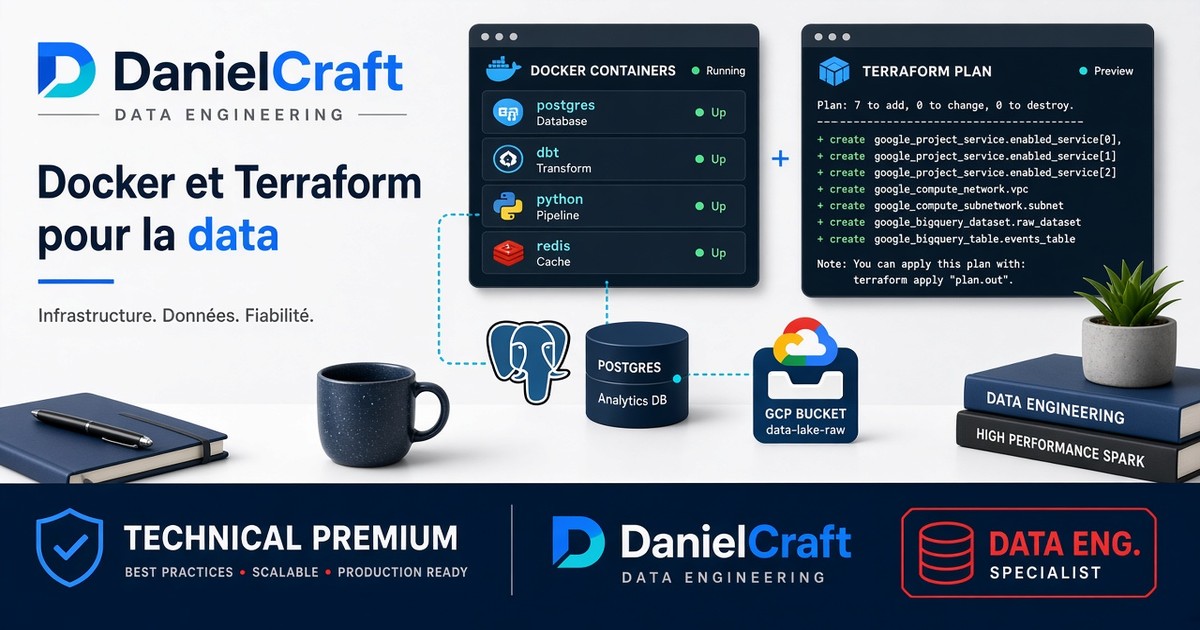
Tutoriel
Docker et Terraform : lab local + infra cloud
Postgres en local avec Docker, infra cloud rejouable avec Terraform - le socle avant les jobs.
Lire l’article →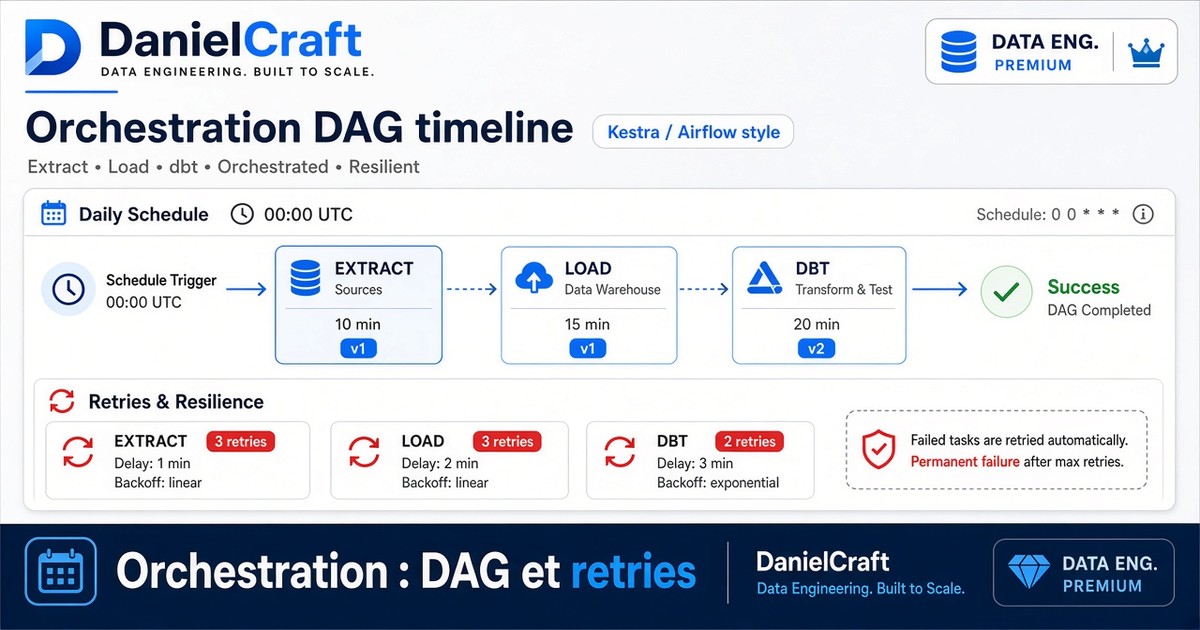
Tutoriel
Orchestration : planifier et surveiller les jobs
Enchaîner les étapes, retenter si ça casse, être alerté - l'esprit Kestra / Airflow sans usine obscure.
Lire l’article →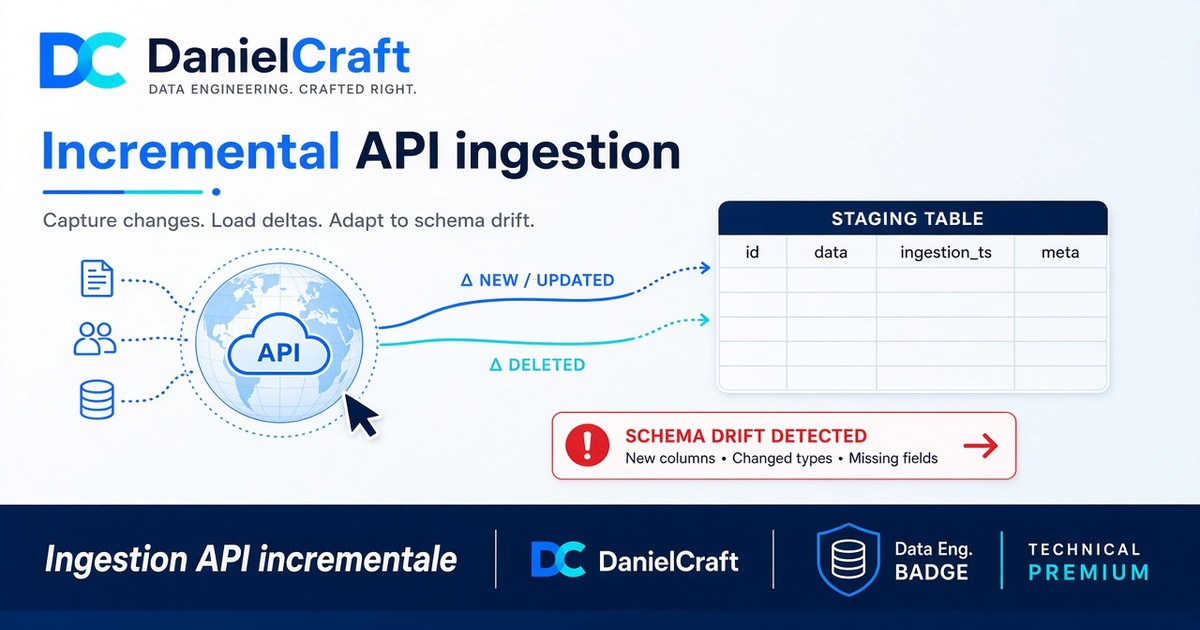
Tutoriel
Ingestion : charger sans tout rejouer
Incrémental, idempotent, normalisé : charger le nouveau sans casser l'historique.
Lire l’article →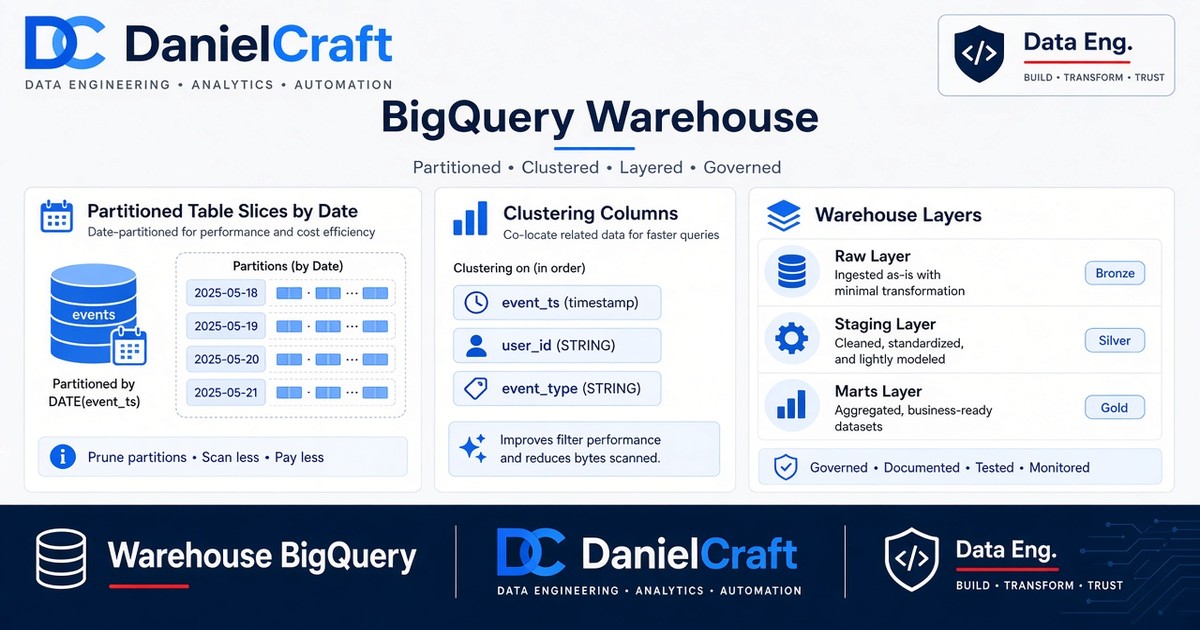
Tutoriel
BigQuery : l'entrepôt pour analyser
Raw, staging, marts : ranger les données pour que le métier puisse interroger sans se perdre.
Lire l’article →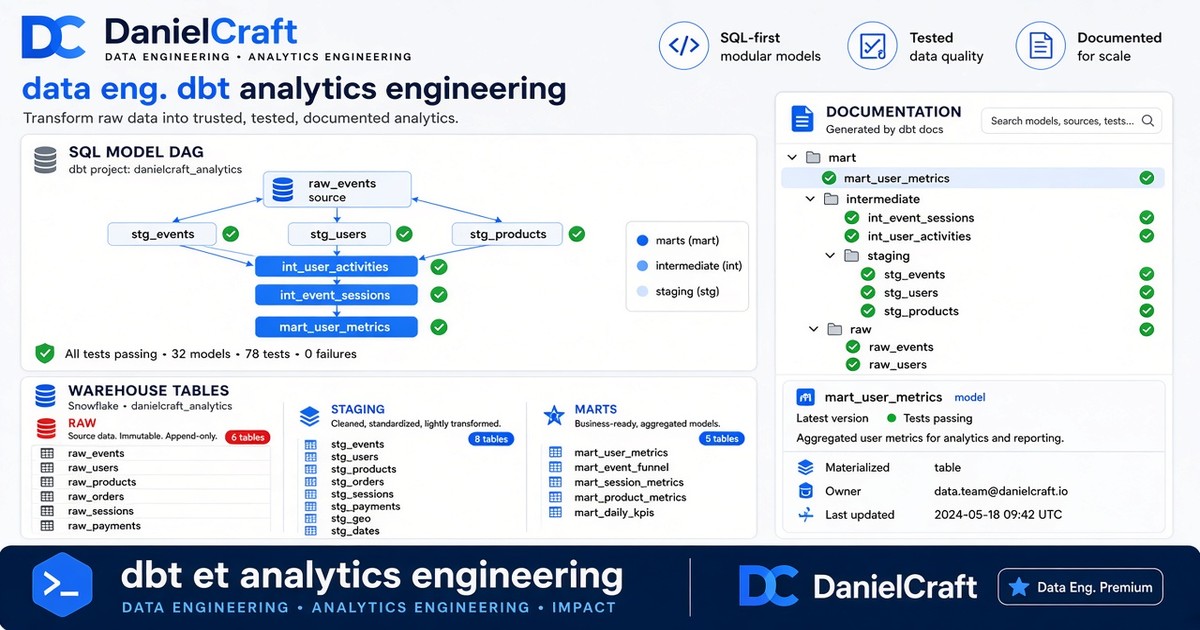
Tutoriel
dbt : transformer en SQL testé
Modèles SQL versionnés, tests, docs : l'analytics engineering sans magie noire.
Lire l’article →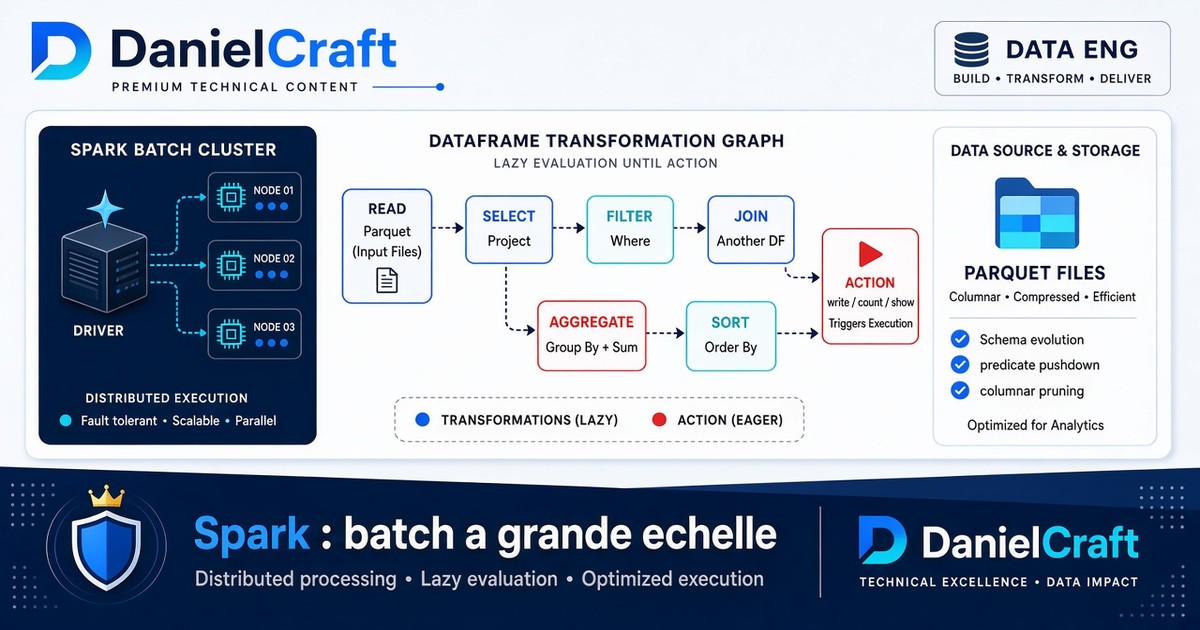
Tutoriel
Spark : gros volumes en batch
Quand le volume explose, Spark (ou équivalent) découpe le travail - sans paniquer.
Lire l’article →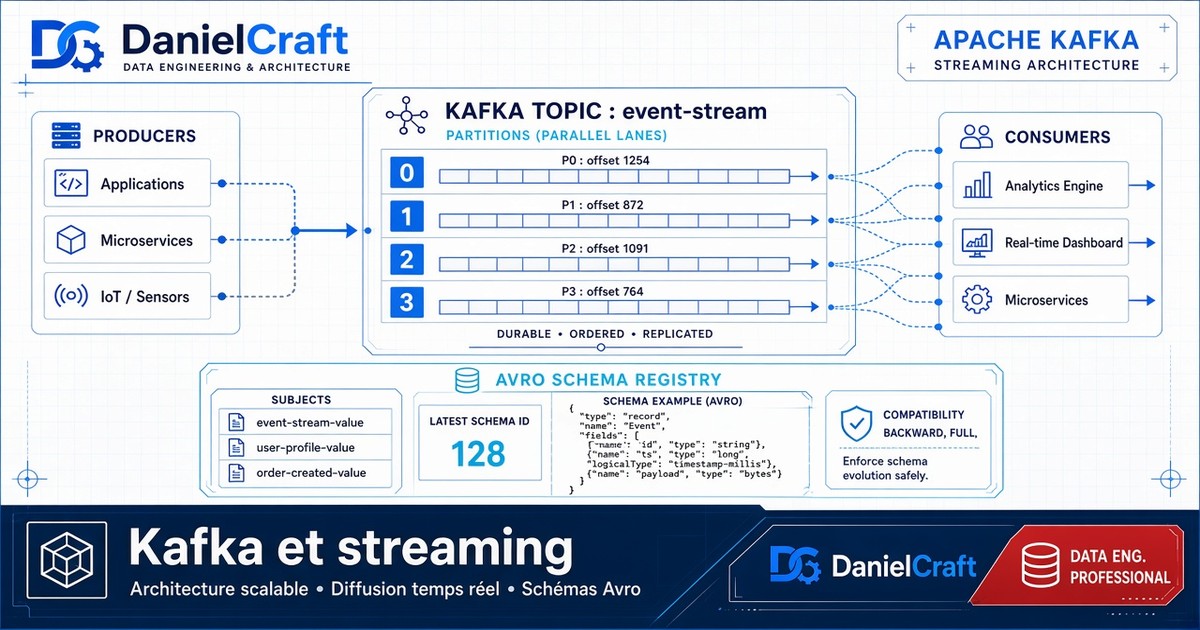
Tutoriel
Kafka : événements en continu
Producers, topics, consumers : comprendre le streaming sans se noyer dans le cluster.
Lire l’article →