Docker et Terraform : lab local + infra cloud
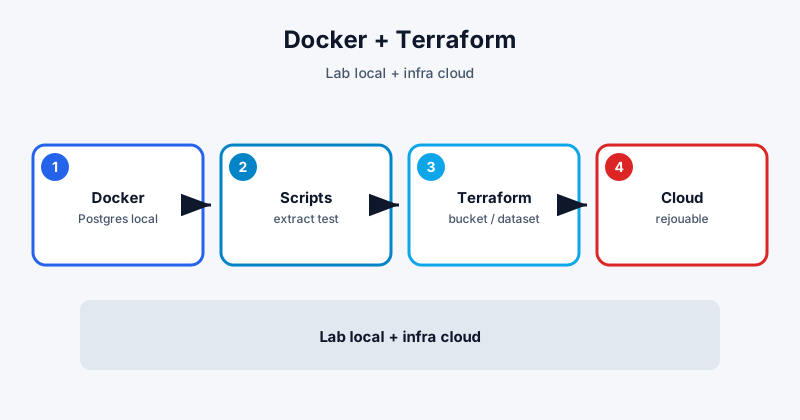
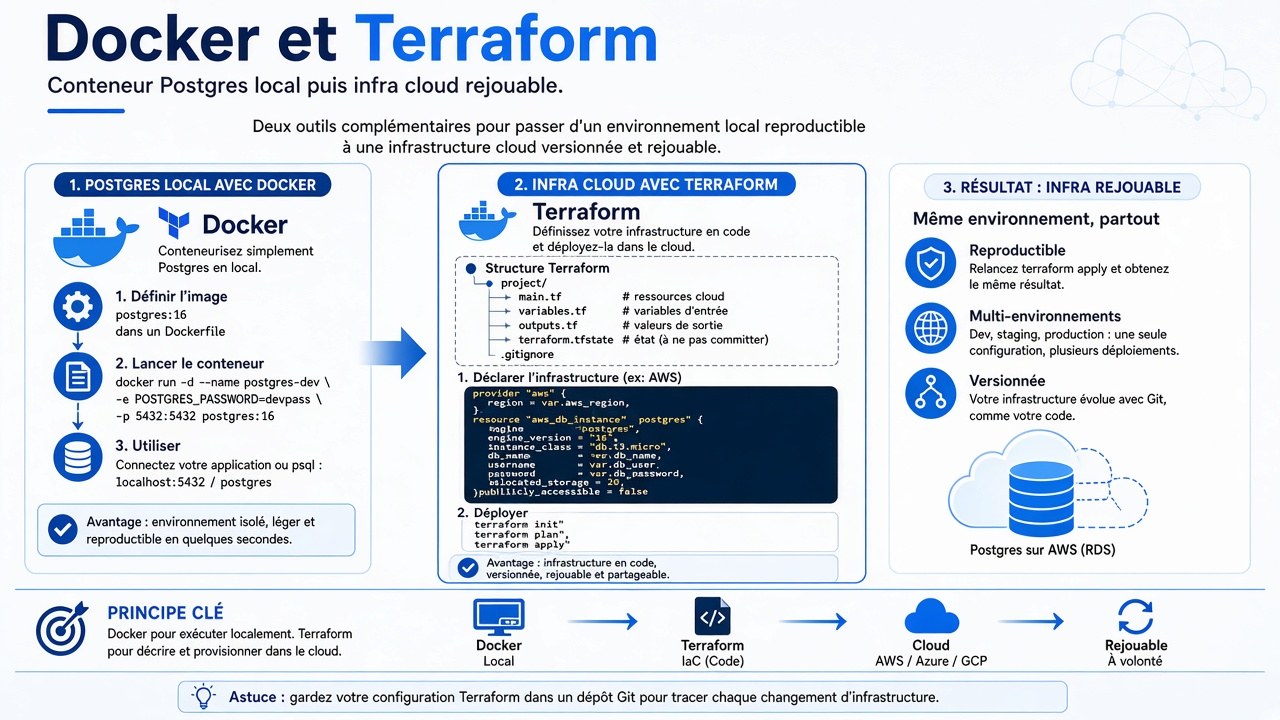
Avant les orchestrateurs fancy et les dashboards qui brillent, tu as besoin d'un socle. Un endroit pour expérimenter chez toi. Une façon de recréer le cloud sans cliquer quarante fois dans une console. C'est le rôle de Docker et de Terraform dans un parcours data engineering.
Cette série s'inspire du Data Engineering Zoomcamp. Ici, on reste en français simple. Pas de prose d'infra pour impressionner. On pose le plancher, ensuite on met les meubles.
L'idée en une phrase
Docker = environnement local isolé. Terraform = décrire le cloud en code pour pouvoir le rejouer.
Pourquoi un lab local ?
Imagine une boutique à Nancy. Tu veux tester un petit pipeline : lire des commandes, les coller dans une base, faire une requête « panier moyen ». Si tu installes Postgres à la main sur ton PC, puis sur celui d'un collègue, puis sur un serveur, tu vas passer plus de temps à « ça marche pas chez moi » qu'à apprendre la data.
Docker te donne une boîte. Dedans : Postgres (ou autre). Tu lances la boîte, tu as la même base de départ que tout le monde. Tu la détruis, tu la relances. Ta machine reste propre.
Tu n'installes pas « la data » sur Windows comme un logiciel magique. Tu lances un service isolé. C'est plus calme pour apprendre.
Docker, en pratique (esprit)
Tu décris souvent :
- une image (le modèle de la boîte) ;
- un conteneur (la boîte qui tourne) ;
- parfois un
docker-compose(plusieurs boîtes qui se parlent : base + outil + interface).
Pour débuter en data, un Postgres local suffit souvent. Tu t'y connectes comme à une vraie base. Tu crées des tables. Tu charges un CSV de commandes d'une boutique lorraine. Tu testes tes requêtes. Personne ne casse la prod du magasin.
Astuce mentale : local = bac à sable. Tu as le droit de tout casser. C'est même le but.
Terraform, c'est quoi le problème qu'il résout ?
Le jour où tu vas dans le cloud (Google Cloud, AWS…), tu crées un bucket, un dataset BigQuery, des droits, parfois un projet. Si tu cliques dans l'interface :
- tu oublies une case ;
- tu ne sais plus ce que tu as créé ;
- un collègue ne peut pas refaire la même chose ;
- « détruire et recommencer » devient un cauchemar.
Terraform dit : l'infra est écrite dans des fichiers. Tu appliques. Le cloud se configure. Tu changes un fichier. Tu réappliques. Tu veux tout virer pour refaire propre ? Tu détruis via le même code.
Ce n'est pas de la magie. C'est de la checklist versionnée. Comme une fiche recettes pour la cuisine du cloud : mêmes ingrédients, même résultat.
Exemple commerce (Lorraine)
Loïc aide une boutique près de Metz. En local, il veut un Postgres pour rejouer des exports de caisse. Dans le cloud, il veut un bucket pour les fichiers bruts et un dataset BigQuery pour les tables d'analyse.
Sans Docker / Terraform :
- Postgres installé « à la main » ;
- bucket créé au feeling ;
- dataset nommé test2_final ;
- personne ne sait comment reproduire.
Avec Docker + Terraform :
- docker compose up → lab prêt ;
- terraform apply → bucket + dataset + droits de base ;
- le même collègue clone le repo et retrouve le même monde.
La boutique n'a pas besoin de comprendre Docker. Elle a besoin que le chiffre du matin soit juste. Toi, tu as besoin que l'environnement soit rejouable.
Ce que tu mets dans le socle (checklist simple)
En local (Docker)
- une base pour expérimenter ;
- éventuellement un outil d'orchestration en mode démo plus tard ;
- des volumes pour garder tes données entre deux redémarrages si besoin.
Dans le cloud (Terraform)
- stockage fichiers (bucket) ;
- entrepôt / dataset ;
- comptes de service et droits minimaux ;
- noms clairs (raw, staging, pas truc_tmp).
Tu n'as pas à tout automatiser le premier jour. Mais dès que tu touches le cloud « pour de vrai », décrire l'infra en code te sauve des soirs entiers.
Erreurs classiques (et comment les éviter)
-
Mélanger lab et prod
Une base Docker locale n'est pas la caisse de la boutique. Ne pointe jamais un script d'essai vers la vraie base « pour aller plus vite ». -
Secrets dans le repo
Clés API, mots de passe, fichiers.tfvarssensibles : hors Git. Variables d'environnement, coffre, fichiers locaux ignorés. -
Tout cliquer « juste pour cette fois »
La fois d'après, tu ne te souviens plus. Si tu cliques, note-le. Mieux : code-le. -
Sur-ingénierie
Une boutique avec 200 commandes / jour n'a pas besoin d'un cluster Kubernetes pour apprendre. Postgres + un bucket, c'est déjà un excellent terrain.
Comment ça se branche sur la suite
Dans les articles suivants, tu vas :
- orchestrer des jobs (planifier, retenter) ;
- ingérer des données sans tout rejouer ;
- charger un entrepôt ;
- transformer avec dbt.
Tout ça suppose un endroit où tourner (local) et un endroit où stocker (cloud). Docker et Terraform, c'est le plancher. Les jobs, c'est le mobilier. Sans plancher, le mobilier trébuche.
En résumé
Reproductible bat « ça marche sur mon PC ».
Socle d'abord, jobs ensuite. Docker pour apprendre tranquille. Terraform dès que le cloud doit être stable et rejouable.
Questions fréquentes (FAQ)
Docker est-il obligatoire dès le jour 1 ?
Pour apprendre tranquillement, oui, c'est très utile. Tu peux coller un Postgres autrement, mais Docker évite beaucoup de « ça dépend de mon PC ».
Terraform dès le premier tutorial ?
Pas forcément. Dès que tu crées des ressources cloud que tu veux garder / partager / détruire proprement, oui.
Docker = production ?
Parfois. Ici, on l'utilise surtout comme lab. La prod cloud, c'est une autre histoire (et souvent d'autres outils).
Je dois apprendre Kubernetes aussi ?
Non pour démarrer. Beaucoup de pipelines sérieux existent sans. Garde ça pour plus tard, si le besoin est réel.
Et si je suis seul sur le projet ?
Le code d'infra te sert quand même : demain-toi, ou toi dans six mois, c'est déjà un autre collègue.
Navigation dans la série
- Précédent : Pipeline intro
- Suivant : Orchestration