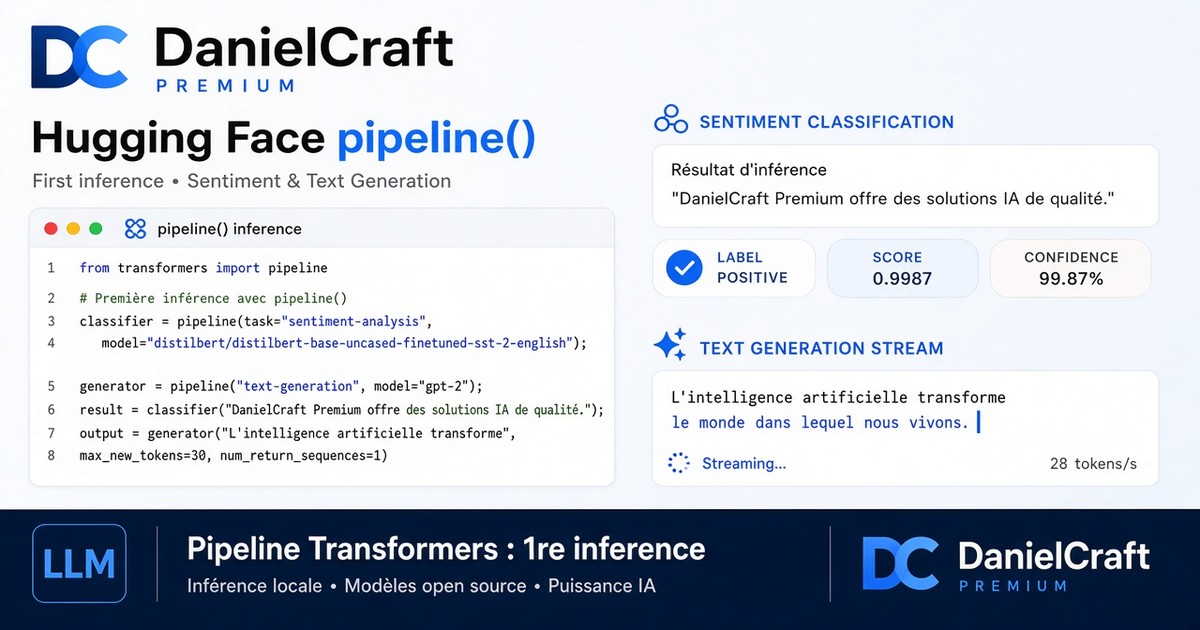
Pipeline Hugging Face : ta première inférence
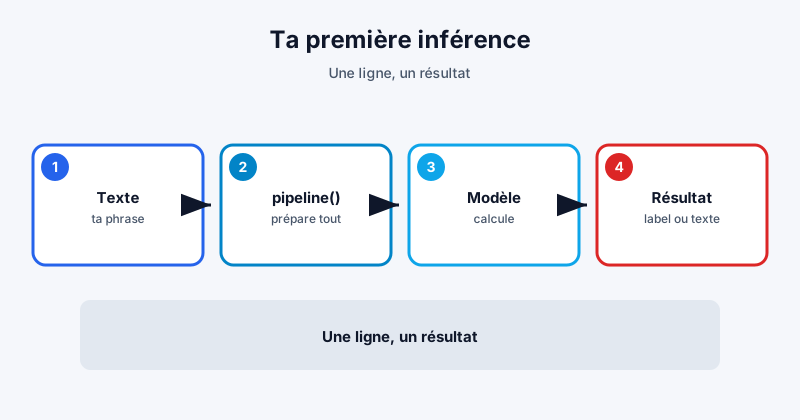
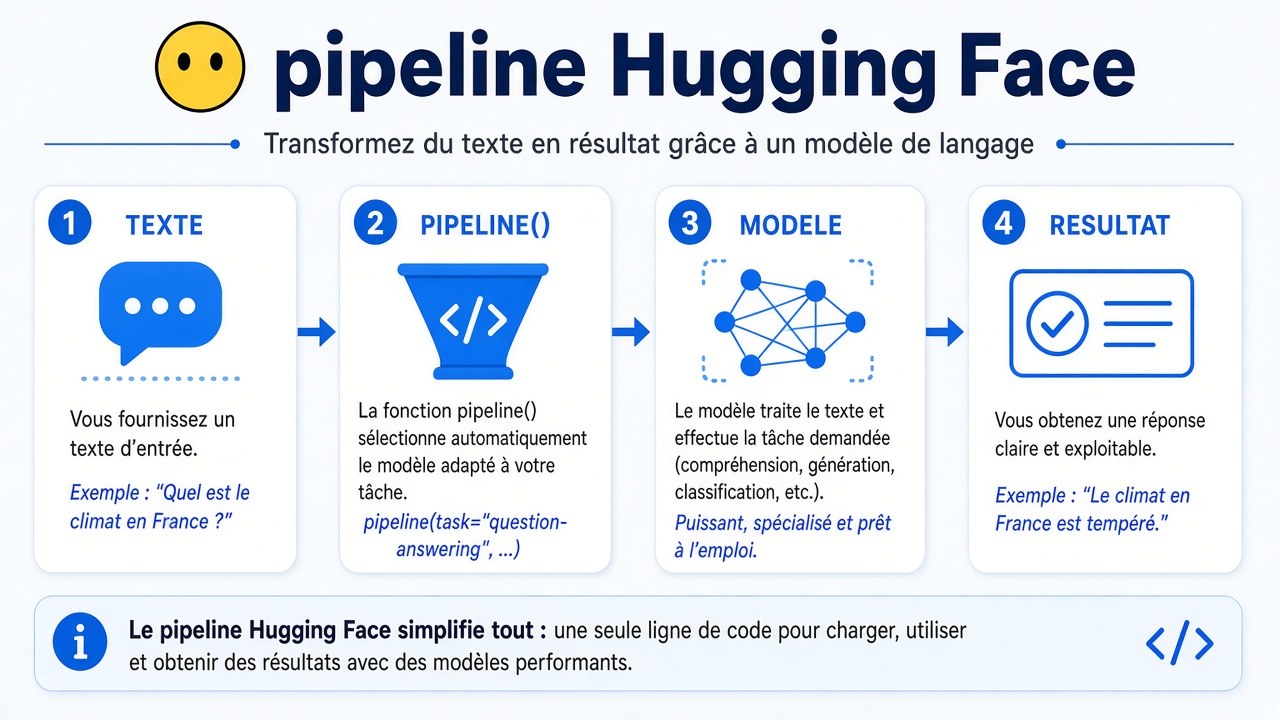
Tu veux un résultat tout de suite, pas un cours de trois heures. pipeline() chez Hugging Face sert exactement à ça : tu donnes une tâche + un texte, tu récupères une sortie.
Inspiration libre du cours LLM Hugging Face. Texte original, français simple. Tu n'as pas besoin de tout comprendre l'architecture avant d'essayer.
L'idée en une phrase
pipeline = un raccourci qui charge le modèle, le tokenizer, et lance le calcul pour toi.
Comme un guichet automatique : tu mets ta phrase, tu choisis le service (classer, générer…), tu récupères un ticket. Le détail des machines derrière, on le verra plus tard.
Installer le minimum
pip install transformers
Selon le modèle, tu auras aussi besoin de torch (ou d'un autre backend). Lis toujours la fiche du modèle (model card) : taille, langue, licence.
Si l'installation te bloque, note l'erreur exacte. Souvent c'est juste une version Python trop vieille, ou un paquet manquant.
Classification en quelques lignes
Cas boutique à Metz : tu reçois des avis Google. Tu veux un premier tri positif / négatif.
from transformers import pipeline

clf = pipeline("sentiment-analysis")
print(clf("Ce magasin est super, j'y retourne."))
Tu obtiens en gros un label et un score. Ce n'est pas une vérité absolue. C'est un indice pour trier plus vite. Sur des avis en français, vérifie que le modèle choisi gère bien le français (sinon change de modèle sur le Hub).
Teste aussi un avis ambigu : « Correct, rien d'exceptionnel. » Tu verras que le score n'est pas toujours net. C'est normal.
Génération (avec prudence)
gen = pipeline("text-generation", model="gpt2")
print(gen("Aujourd'hui à Metz,", max_new_tokens=40))
Un petit modèle de démo invente facilement. Pour un vrai usage métier (mail client, fiche produit), choisis un modèle adapté à ta langue, fixe une limite de tokens, et relis avant d'envoyer quoi que ce soit.
Règle DanielCraft : l'outil propose, toi tu assumes.
Ce qui se passe sous le capot
- ton texte arrive ;
- le tokenizer le découpe en tokens (morceaux) ;
- le modèle calcule ;
- la sortie redevient un label ou du texte.
pipeline cache ces étapes. Dans la suite de la série, on ouvrira le capot (architectures, Hub, tokenizers, fine-tuning).
Choisir une tâche claire
Avant de coder, écris une phrase :
- « Je classe des avis en positif / négatif. »
- « Je résume une fiche produit en 3 lignes. »
- « Je propose un brouillon de réponse mail. »
Si tu ne peux pas l'écrire clairement, le modèle ne sauvera pas le flou.
Pièges fréquents
- lancer un modèle trop gros sur une machine trop petite ;
- ignorer la langue du modèle ;
- croire que le score = vérité ;
- coller la sortie telle quelle sur un site client ;
- oublier la licence / les conditions d'usage.
Mini checklist avant de montrer à quelqu'un
- 10 vrais exemples de ton métier testés ;
- 2 cas limites (ironique, faute d'ortho, phrase courte) ;
- tu sais dire ce que le modèle ne fait pas ;
- tu as une relecture humaine sur ce qui part au client.
En résumé
pipeline = le plus court chemin pour tester. Une tâche, un texte, un résultat. Ensuite tu peaufines : meilleur modèle, puis éventuellement fine-tuning ou agents avec outils.
Prochaine étape : comprendre encoder / decoder pour choisir la bonne famille.
Questions fréquentes (FAQ)
Ça marche hors ligne ?
Après le premier téléchargement du modèle, souvent oui - selon ta config et le modèle.
Quel modèle choisir ?
Commence petit, lis la model card, teste sur tes textes. Le plus célèbre n'est pas toujours le plus adapté.
Faut-il un GPU ?
Pas pour démarrer sur des petits modèles de classification.
Le score à 0,99 veut dire que c'est sûr ?
Non. Ça mesure une confiance interne, pas une preuve métier.
Je peux mettre ça en prod demain ?
Un proto oui. En prod : validation, logs, et un humain sur les cas sensibles.
Navigation dans la série
- Précédent : NLP vs LLM
- Suivant : Encoder, decoder : quelle architecture ?