dbt : transformer en SQL testé
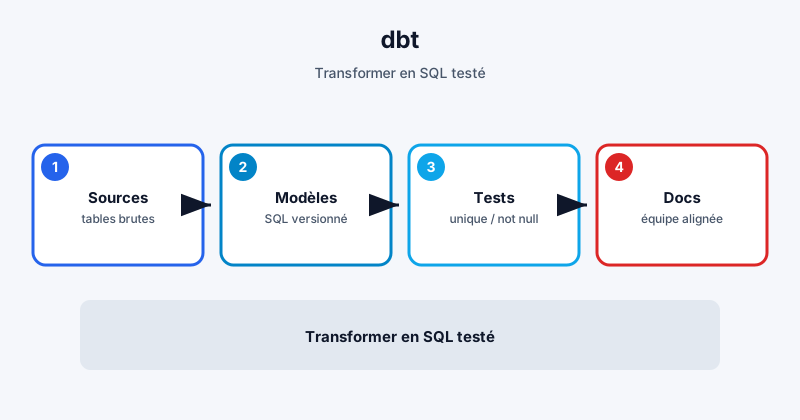
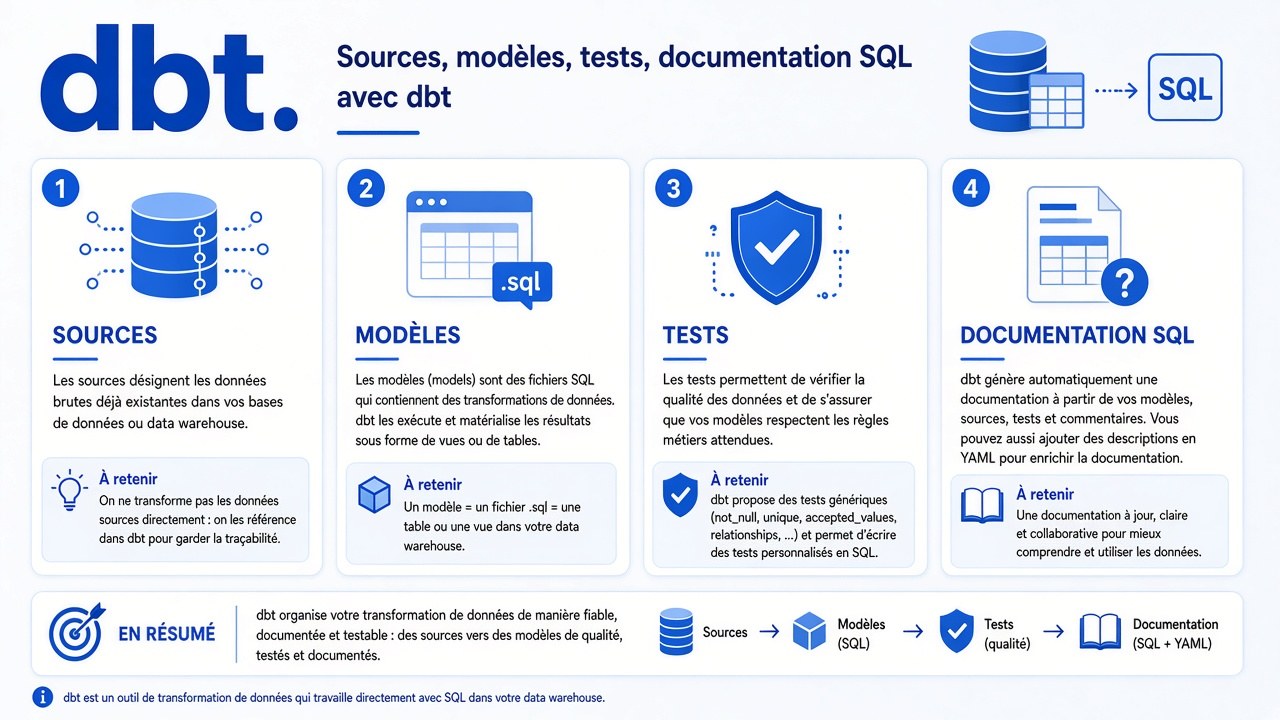
dbt, c'est (surtout) du SQL versionné avec des tests et de la doc. Tu transformes dans l'entrepôt, en équipe, sans coller la « requête de Kevin » dans un pad oublié. On appelle souvent ça l'analytics engineering : rendre la couche métier aussi soignée que le code d'appli.
Cette série s'inspire du Data Engineering Zoomcamp. Ici, on reste pédagogique. Pas besoin d'être expert SQL le premier jour - tu progresses modèle après modèle.
L'idée en une phrase
Chaque modèle = un fichier SQL clair, testable, documenté.
Le problème que dbt règle
Sans dbt (ou équivalent), la transform ressemble souvent à ça :
- une requête dans un outil BI ;
- une autre dans un script ;
- une troisième « version finale » dans un mail ;
- personne ne sait laquelle est la vérité du panier moyen.
Avec dbt : des fichiers dans Git, des dépendances claires, des tests, une doc générée. La boutique à Metz qui demande « c'est quoi le CA hier ? » obtient une définition, pas trois.
Sources → modèles → tests → docs
Sources
Tu déclares d'où vient le brut (raw.commandes, etc.). dbt ne remplace pas l'ingestion. Il part de ce qui est déjà chargé.
Modèles
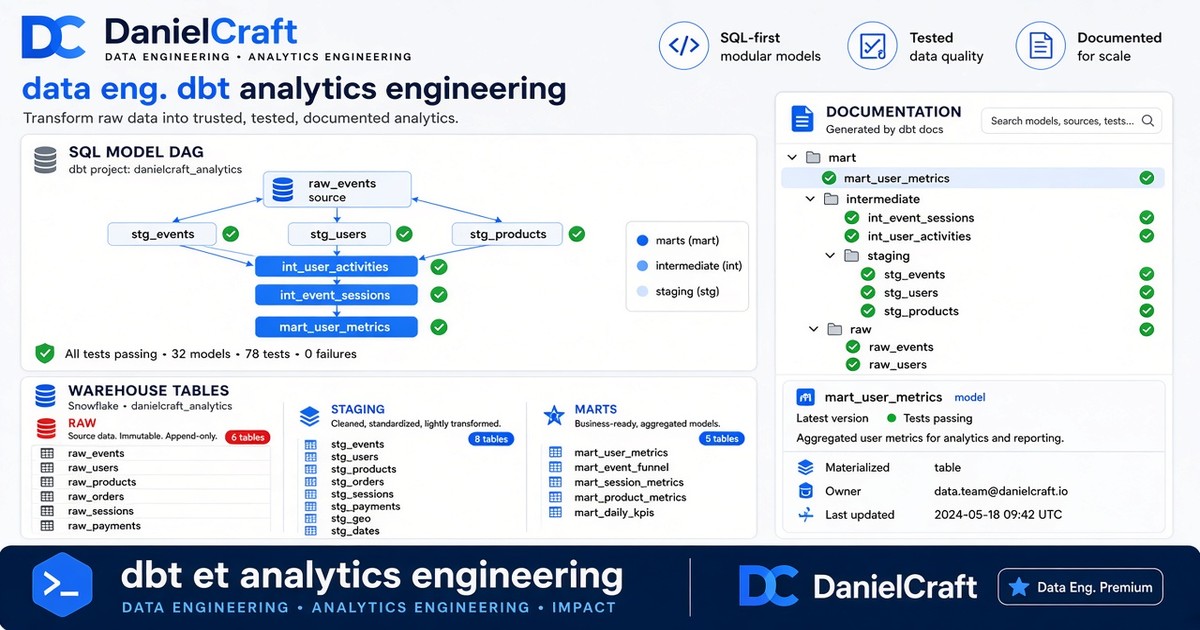
Un fichier SQL = une table (ou vue) construite. Souvent : staging d'abord, puis marts. Tu enchaînes avec des ref() : « ce modèle lit celui-là ». L'ordre de build devient un graphe, pas une checklist mentale.
Tests
Exemples utiles dès le début :
- unicité de l'id commande ;
- pas de
nullsur le montant ; - valeurs acceptées pour le statut (
paye,annule…).
Si un test casse après le run de nuit, tu le sais avant que le gérant ouvre le dashboard.
Docs
Descriptions des colonnes, origine, règles. L'équipe (et toi dans six mois) comprend sans archéologie.
Exemple boutique (Lorraine)
Flux dbt simple pour une boutique près de Nancy :
stg_commandes: types propres, fuseau, trim ;stg_promo: codes promo normalisés ;fct_commandes: jointure commande + promo ;mart_panier_jour: agrégats pour le dashboard.
Tests : id unique sur fct_commandes, montant > 0 sauf annulations. Doc : « panier moyen = CA / nb commandes payées, hors retrait magasin gratuit ».
Le métier n'ouvre pas dbt. Il ouvre le graphique. Toi, tu dors un peu mieux parce que le SQL a une adresse dans le repo.
Ce que tu gagnes
- historique Git (qui a changé la règle du panier ?) ;
- tests (unicité, null, relations) ;
- doc pour l'équipe ;
- moins de « la requête de Kevin dans un pad » ;
- un run reproductible (
dbt run/dbt test) branchable sur l'orchestrateur.
Ce que dbt n'est pas
Ce n'est pas l'ingestion.
Ce n'est pas Kafka.
Ce n'est pas obligatoire d'écrire du Python complexe pour démarrer - le SQL suffit très loin.
Ce n'est pas la peine de inventer 80 macros le premier mois. Des modèles simples et testés battent une cathédrale vide.
Comment ça se branche sur le reste
L'orchestrateur lance dbt run puis dbt test après l'ingestion. L'entrepôt (BigQuery ou autre) héberge les tables. Si le volume devient énorme et que SQL seul rame, Spark peut entrer avant ou à côté pour certains jobs lourds. Pour beaucoup de commerces du Grand Est, dbt + entrepôt, c'est le cœur du tuyau analytique.
Erreurs classiques
-
Logique métier dans le dashboard seulement
Reproduis-la dans un modèle. Le dashboard consomme, il ne définit pas. -
Zéro test
« Ça a l'air bon » n'est pas un test. Commence par unicité + not null sur les clés. -
Modèles fourre-tout
Un fichier de 800 lignes illisible. Découpe staging / marts. -
Changer la définition sans le dire
Le panier moyen « hors retours » depuis mardi ? Documente et annonce. Sinon le métier compare des pommes et des mirabelles.
En résumé
dbt ne remplace pas l'ingestion. Il range la transformation analytique.
SQL versionné + tests + doc = la transform devient un produit d'équipe, pas un secret de tiroirs.
Prochaine étape : Spark, quand le volume batch dépasse ce qu'une approche simple digère bien.
Questions fréquentes (FAQ)
Faut-il être expert SQL ?
Tu progresses. Les modèles simples suffisent pour démarrer. Lisibilité > astuces obscures.
dbt Cloud obligatoire ?
Non. Tu peux commencer en local / CLI. Cloud = confort d'équipe plus tard.
dbt remplace l'orchestrateur ?
Non. dbt transforme. L'orchestrateur planifie (ingestion → dbt → suite).
Je peux utiliser dbt avec Postgres ?
Oui, selon ton setup. L'esprit modèles / tests / docs reste. BigQuery n'est qu'un exemple fréquent.
Combien de modèles au début ?
Trois à cinq bien nommés battent trente fichiers vides. Une boutique, une question métier claire, un mart.