Fine-tuning : adapter un modèle à ton métier
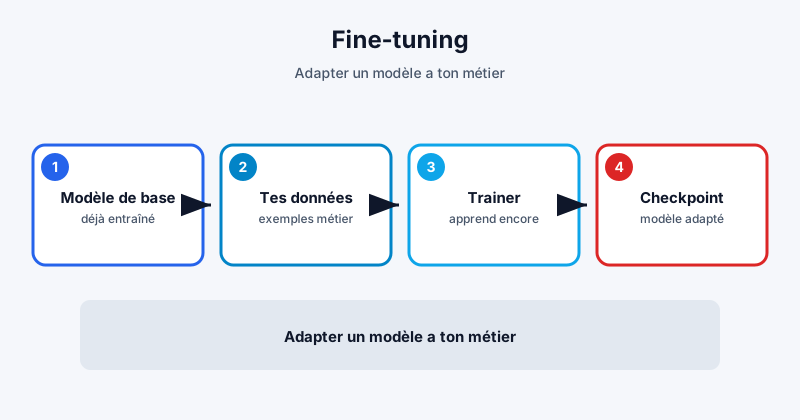
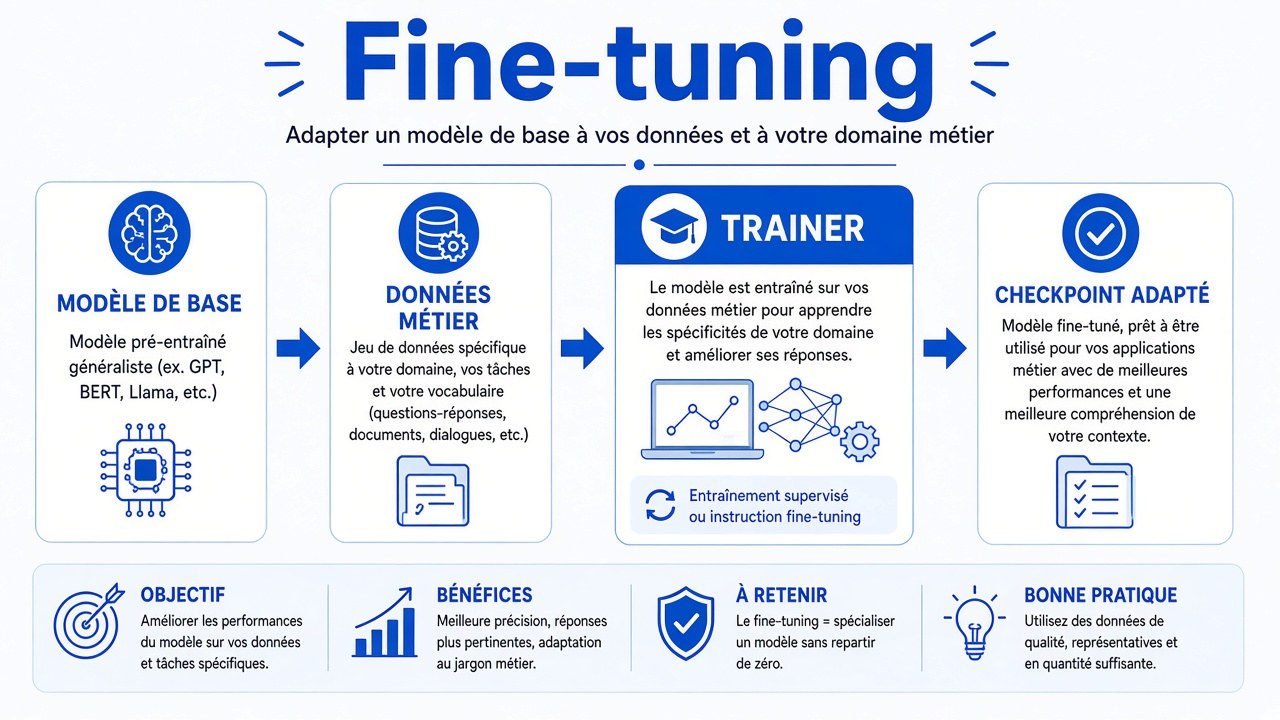
Fine-tuning = tu prends un modèle qui sait déjà lire ou écrire, et tu lui montres tes exemples pour qu'il s'aligne sur ton cas. Tu ne reconstruis pas tout depuis zéro. Tu adaptes.
C'est un peu comme former un nouveau vendeur : il sait déjà parler français. Toi, tu lui montres comment on répond aux devis dans ta boutique, avec tes délais.
Cette série s'inspire du cours LLM Hugging Face. Ici, on reste concret et débutant-friendly.
L'idée en une phrase
Pas tout reconstruire : adapter.
Modèle de base + données propres + entraînement contrôlé = version métier.
Quand c'est utile
- tes libellés métier ne sont pas dans le modèle général (« devis vitrine », « SAV atelier », ton jargon) ;
- le prompt seul ne suffit pas (tu répètes toujours les mêmes consignes, et ça dérive) ;
- tu as un minimum d'exemples propres (même quelques centaines pour classer) ;
- tu veux plus de stabilité qu'un gros chat généraliste.
Exemple (Metz)
Tu classifies les messages du formulaire contact : devis site, urgence technique, simple question horaires. Un modèle général se trompe souvent. Après fine-tuning sur tes vrais messages, ça devient beaucoup plus net.
Quand ce n'est pas la première option
- tu n'as presque aucune donnée (commence par en collecter) ;
- un petit classifieur dédié + règles simples suffit ;
- tu peux résoudre le besoin avec des outils (horaires, stock) plutôt qu'avec un modèle qui invente - souvent le cas côté agents ;
- tu n'as pas encore testé un modèle « déjà prêt » sur le Hub.
Règle simple : essaie d'abord sans fine-tuning. Si c'est déjà bon à 90 % sur tes textes, peut-être que tu n'as pas besoin d'entraîner.
Déroulé simple
- Modèle de base choisi (bonne tâche, bonne langue, taille raisonnable).
- Dataset propre (labels clairs, train / test séparés - voir l'article tokenizers).
- Entraînement avec un outil type Trainer (Hugging Face) ou équivalent : tu lances des passes sur tes exemples.
- Évaluation sur des cas réels (pas seulement le score magique).
- Checkpoint sauvegardé : une version figée de ton modèle adapté.
- Test humain : tu lis 20 sorties. Tu valides le ton et les erreurs.
Un checkpoint, c'est une sauvegarde du modèle à un moment donné. Garde aussi la trace du modèle de base : tu sauras d'où tu es parti.
Ce que « entraîner » veut dire (sans maths)
À chaque exemple, le modèle propose une réponse (une classe, un texte…). On compare à la vérité. On ajuste un peu les poids internes pour se rapprocher. On répète.
Tu n'as pas besoin de tout calculer à la main. Les libs s'occupent du détail. Toi, tu surveilles :
- les données ;
- le temps / la mémoire ;
- le résultat sur le jeu de test ;
- les erreurs humaines (faux positifs, ton bizarre).
Hyperparamètres : le minimum utile
Tu vas croiser des mots comme « learning rate » (vitesse d'apprentissage) ou « epochs » (combien de fois on repasse sur le dataset).
Version simple :
- trop vite / trop longtemps → le modèle mémorise au lieu de généraliser (overfitting) ;
- trop peu → il n'apprend presque rien.
Au début : garde les valeurs recommandées du tutoriel / de la fiche, change une chose à la fois, et mesure.
Exemple déroulé boutique (Lorraine)
Objectif : classer les avis Google en positif / négatif / neutre.
- Tu labels 300 avis.
- Tu en gardes 60 pour le test.
- Tu pars d'un petit modèle de classification français (ou multilingue).
- Tu lances un fine-tuning court.
- Tu regardes les erreurs : souvent les avis mixtes (« top produit, mais délai long »).
- Tu clarifies la règle de label, tu enrichis un peu, tu ré-entraînes.
Tu n'as pas besoin d'un supercalculateur pour ça. Un petit modèle bien cadré suffit souvent.
Pièges fréquents
Données sales. Le fine-tuning amplifie tes erreurs de label.
Pas de jeu de test. Tu celebrates un score qui ment.
Modèle trop gros trop tôt. Coût, lenteur, complexité. Commence léger.
Oublier la relecture. Même adapté, un modèle peut se tromper. Sur un mail client, tu valides.
Fine-tuner pour tout. Parfois un bon prompt + un outil (horaires) est plus simple et plus sûr.
Lien avec Gradio et LoRA
Ensuite, tu pourras montrer ton modèle avec Gradio (petite interface de test). Plus tard, LoRA : une façon d'adapter un gros modèle sans tout réécrire - utile quand le fine-tuning « complet » devient trop lourd.
En résumé
Fine-tuning = spécialisation contrôlée.
Données propres d'abord. Modèle de base adapté à la tâche. Mesure sur des cas réels. Checkpoint sauvegardé. Relecture humaine sur ce qui compte.
Questions fréquentes (FAQ)
Ça écrase le modèle de base ?
Tu produis une version adaptée (checkpoint). Garde une trace de la base et de ta config. Tu peux toujours revenir en arrière.
Combien de temps ?
De quelques minutes à plusieurs heures, selon la taille du modèle, le volume de données, et ta machine (CPU, GPU).
Faut-il une carte graphique ?
Pour les petits modèles de classification, parfois non. Pour les gros modèles de génération, souvent oui - ou un cloud.
Le prompt ne suffit jamais ?
Parfois si. Fine-tune quand le prompt plafonne, ou quand tu veux plus de stabilité sur un volume répété.
Combien d'exemples minimum ?
Ça dépend. Pour classer, quelques centaines propres aident déjà. Pour générer du texte métier, regarde la qualité plus que le chiffre magique.
Navigation dans la série
- Précédent : Tokenizers
- Suivant : Démo Gradio