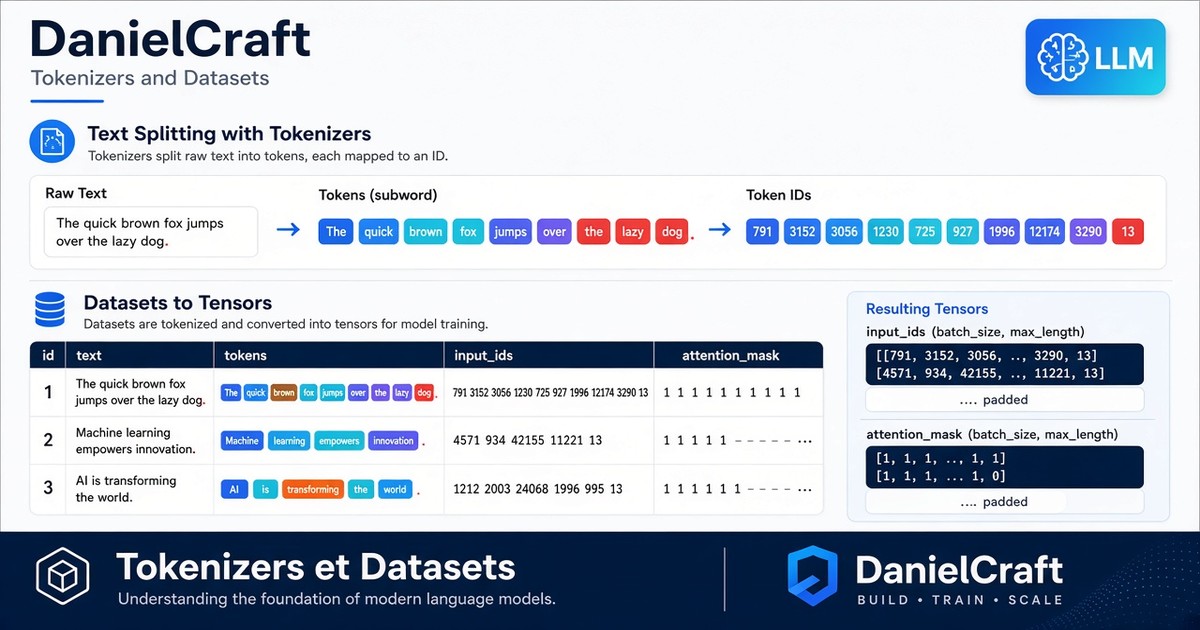
Tokenizers et datasets : préparer le texte
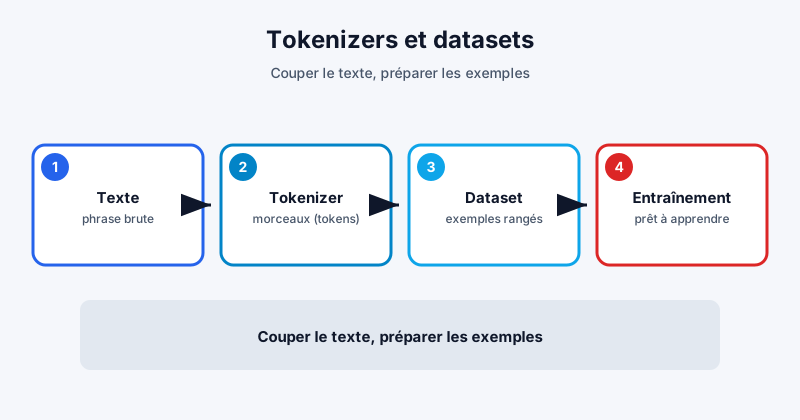
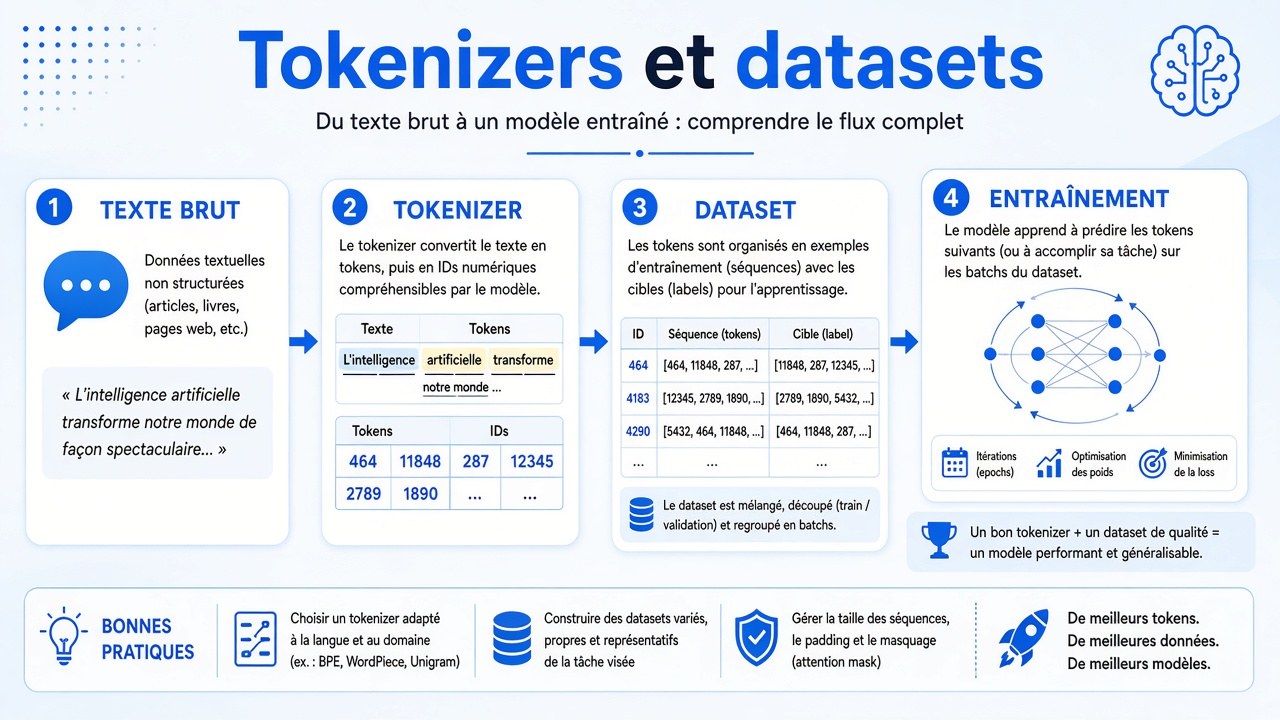
Le modèle ne lit pas des phrases comme toi. Il lit des tokens (des morceaux de texte). Et pour apprendre, il a besoin d'exemples bien rangés : c'est le dataset.
Cette étape paraît un peu « cuisine ». En vrai, c'est là que beaucoup de projets se sauvent - ou se cassent. Un beau modèle avec un mauvais découpage, ça donne des résultats bizarres.
Cette série s'inspire du cours LLM Hugging Face. On reste pédagogique, sans jargon gratuit.
L'idée en une phrase
Tokenizer = découpe le texte. Dataset = tes exemples prêts.
Sans ces deux briques, tu n'entraînes pas : tu improvises.
C'est quoi un token ?
Imagine que tu découpes une phrase en briques Lego. Pas forcément mot par mot. Parfois un mot entier, parfois un bout de mot, parfois un signe de ponctuation.
Exemple (idée, pas une découpe exacte) :
« Le devis arrive sous 3 jours. »
Le tokenizer peut découper en plusieurs tokens. Le modèle, lui, travaille avec ces briques - et avec des numéros associés. Toi, tu continues à penser en phrases. Lui, en séquence de tokens.
Pourquoi ça compte ? Parce que chaque modèle a son tokenizer. Si tu découpes avec le mauvais, le modèle « lit » de travers.
Pourquoi le tokenizer compte
Mauvais tokenizer / mauvais découpage → résultats bizarres, scores foireux, entraînement qui n'apprend pas ce que tu crois.
Bon réflexe : tu réutilises le tokenizer du modèle choisi. Tu ne réinventes pas la découpe « à la main » pour briller. Rarement utile au début.
Autres points simples :
- la longueur maximale : trop de texte → il faut tronquer ou découper ;
- les caractères spéciaux, accents, emojis : le tokenizer du modèle sait (ou pas) les gérer ;
- le français : un tokenizer entraîné surtout sur l'anglais peut découper moins efficacement tes textes métier.
Pour une boutique à Metz, tes avis parlent d'horaires, de devis, parfois d'un ton local. Teste sur tes phrases, pas seulement sur un exemple anglais du tutoriel.
C'est quoi un dataset (ici) ?
Un dataset, c'est ta matière première rangée. Souvent :
- des textes + des labels (ex. positif / négatif / neutre) ;
- ou des paires entrée / sortie (ex. long texte → résumé) ;
- ou des questions / réponses.
Avec la lib datasets de Hugging Face, tu charges, tu filtres, tu mélanges, tu sépares en train / test. « Train », c'est pour apprendre. « Test » (ou validation), c'est pour mesurer sans tricher.
Qualité > volume bruité
Pour un commerce : 200 avis bien labellisés valent mieux que 10 000 lignes douteuses.
Doublons, labels inversés, copier-coller bancals : le modèle apprend ça aussi. Il ne « comprend » pas que tu as fait une erreur de clic.
Ce que tu fais concrètement
- tu as des textes + labels (ou paires entrée/sortie) ;
- tu nettoies un minimum (doublons, lignes vides, labels incohérents) ;
- tu tokenizes comme le modèle s'y attend ;
- tu ranges ça dans un dataset (souvent via la lib
datasets) ; - tu sépares un jeu de test ;
- tu lances l'entraînement ou l'évaluation.
Tu n'as pas besoin de tout coder parfaitement du premier coup. Mais l'ordre compte : propre → tokens → dataset → train.
Exemple boutique (Lorraine)
Tu classifies les mails reçus : devis, SAV, spam.
- Tu exportes 250 mails (anonymisés si besoin).
- Tu labels à la main (ou à deux, pour vérifier).
- Tu gardes 50 mails pour le test - tu ne les utilises pas pour entraîner.
- Tu tokenizes avec le tokenizer du modèle choisi.
- Tu entraînes. Tu mesures sur les 50.
Si ça se trompe encore sur le SAV, tu regardes les erreurs : souvent, le label était flou, ou le mail mélangeait deux sujets. Tu corriges les données. Tu ré-entraînes. C'est normal.
Erreurs classiques (débutant)
Inventer son tokenizer. Sauf cas très avancé, non. Prends celui du modèle.
Mélanger train et test. Si le modèle a déjà vu l'exemple, ton score est trop beau. Il ment un peu - sans le vouloir.
Ignorer la longueur. Un avis de 3 lignes ≠ un roman. Si tu tronques trop, tu perds le sens. Si tu forces trop long, ça coûte cher en mémoire.
Labels flous. « Plutôt positif ? » n'est pas une classe. Décide des règles simples avant de labelliser.
Tout en anglais, prod en français. Les datasets publics sont souvent anglophones. Adapte ou construis le tien.
Mini check-list avant d'entraîner
- [ ] Mes labels sont clairs et cohérents
- [ ] J'ai enlevé les doublons évidents
- [ ] J'utilise le tokenizer du bon modèle
- [ ] J'ai un jeu de test séparé
- [ ] J'ai testé 10 exemples à la main après tokenization (ça a l'air raisonnable)
Si une case est rouge, pause. Tu gagneras du temps.
Lien avec la suite
Ensuite : le fine-tuning - adapter un modèle avec ces exemples propres. Puis Gradio pour montrer le résultat, et LoRA pour adapter sans tout réécrire.
La cuisine tokens + dataset, c'est le socle. Sans ça, le fine-tuning tourne à vide.
En résumé
Tokens = langage machine. Dataset = ta matière première.
Propre avant rapide. Tokenizer du modèle, pas le tien. Qualité locale avant volume lointain.
Questions fréquentes (FAQ)
Je dois écrire mon tokenizer ?
Rarement. Tu réutilises celui du modèle. C'est le choix par défaut, et le plus sûr.
Combien d'exemples ?
Ça dépend de la tâche. Commence petit (quelques centaines bien faites), mesure, puis enrichis. Mieux vaut 300 justes que 3000 sales.
Train / test, c'est quoi ?
Train = pour apprendre. Test = pour mesurer sur des exemples jamais vus. Sinon tu te mens sur la qualité.
Les accents français cassent le tokenizer ?
En général non, si le modèle est prévu pour le français ou le multilingue. Teste quand même avec tes vrais textes.
Je peux mélanger plusieurs datasets ?
Oui, avec prudence. Vérifie que les labels veulent dire la même chose. Sinon tu mélanges des pommes et des devis.
Navigation dans la série
- Précédent : Hub
- Suivant : Fine-tuning