NLP vs LLM : comprendre la différence sans jargon
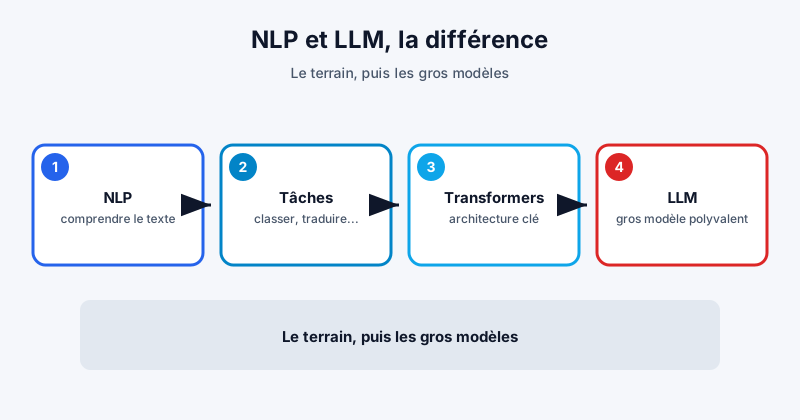
Tu croises NLP, LLM, Transformers partout. Trois mots collés, souvent sans vraiment dire ce qui change. Ici on va doucement. Tu n'as pas besoin d'être ingénieur pour suivre.
Cette série s'inspire du cours LLM Hugging Face. Le texte est original, en français, clarté d'abord.
L'idée en une phrase
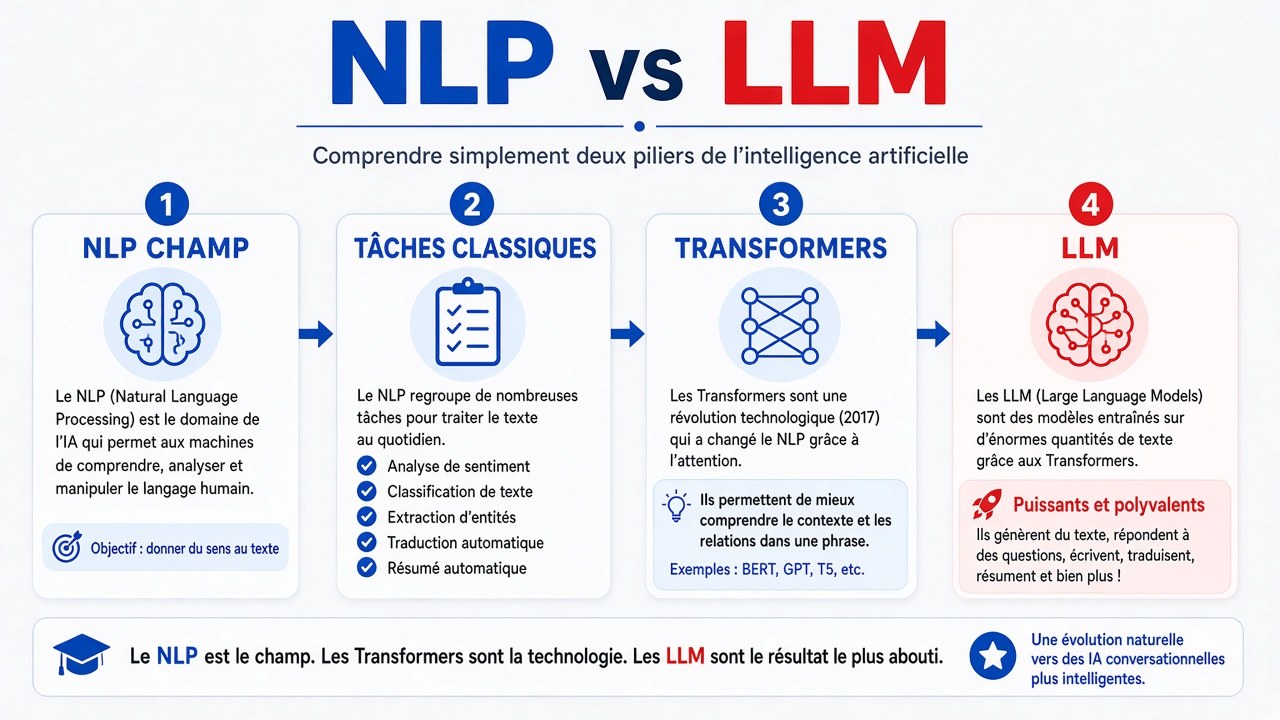
NLP = le terrain (faire comprendre / produire du texte à une machine).
Transformer = une façon de construire le modèle.
LLM = un gros modèle de langage, souvent basé sur cette architecture.
NLP, c'est quoi ?
Le NLP (traitement du langage), c'est toutes les méthodes pour qu'une machine lise, classe ou écrive du texte.
Exemples concrets : - avis client positif ou négatif ; - trouver un nom, une date, une ville dans un mail ; - traduire ; - résumer ; - répondre à une question.
Avant, on faisait souvent un modèle par tâche. Un pour le sentiment, un autre pour la traduction. Ça marchait, mais c'était lourd à maintenir.
LLM, c'est quoi ?
Un LLM (gros modèle de langage), c'est un modèle entraîné sur énormément de texte. Il apprend à prédire le prochain morceau (on dit token).
Ce n'est pas magique. C'est toujours du NLP - juste à plus grande échelle.
Ce qui change pour toi : - un même modèle peut faire plusieurs choses via une consigne (le prompt) ; - tu peux l'adapter à ton métier (fine-tuning) ; - l'écosystème (Hub, démos) rend les essais plus accessibles.
Et les Transformers ?
C'est l'architecture derrière beaucoup de modèles modernes (depuis 2017). L'idée clé : l'attention - le modèle regarde tout le contexte utile en parallèle, au lieu de lire mot à mot comme avant.
Tu croises des familles : - encoder : comprendre / classer ; - decoder : générer du texte ; - les deux : traduire / résumer.
On détaille ça dans un prochain article.
Différence qui compte vraiment
| NLP spécialisé | LLM généraliste | |
|---|---|---|
| Sortie | souvent une étiquette claire | texte libre (parfois inventé) |
| Données | beaucoup de labels par tâche | gros pré-entraînement, puis un peu de métier |
| Coût | souvent léger | peut demander GPU / budget |
| Contrôle | prévisible | il faut des garde-fous |
Règle simple : si tu veux juste classer des avis, commence petit. Si tu veux un assistant qui rédige, regarde du côté LLM - avec validation humaine.
Premier contact (idée)
Avec Hugging Face, tu peux tester une classification en quelques lignes (pipeline). On le fait proprement dans l'article suivant. Ici, retiens juste : tu n'as pas besoin de tout comprendre avant d'essayer une petite tâche claire.
Par où démarrer
- choisis une tâche (classer, résumer, chatter) ;
- teste un petit modèle via
pipeline; - lis la fiche du modèle (model card) ;
- monte ensuite : tokenizers, fine-tuning, démo.
Côté DanielCraft : j'utilise l'IA pour aller plus vite, et je contrôle avant de livrer. Même logique avec un LLM.
Lien avec les autres séries
Une fois les bases LLM en place :
- pour faire agir le modèle avec tes outils métier → série Agents ;
- pour des tuyaux de données fiables (sources → entrepôt) → série Data Engineering.
Les trois parcours se complètent : comprendre le texte, brancher des outils, alimenter avec des données propres.
En résumé
NLP = le champ. Transformers = l'architecture dominante. LLM = gros modèles NLP polyvalents.
Commence simple. Une tâche claire bat un jargon impressionnant.
Prochaine étape : ta première inférence avec pipeline().
Questions fréquentes (FAQ)
Un LLM, c'est du NLP ? Oui. C'est une famille de modèles NLP à grande échelle.
Faut-il un énorme modèle ? Non. Pour classer des avis, un petit modèle suffit souvent.
Par où commencer ? Une tâche claire + pipeline() Hugging Face.
Ça remplace mon métier ? Non. Ça accélère. Toi tu valides.
Et après cette série ? Les agents (outils + boucle) et/ou le data engineering (tuyaux).