Ingestion : charger sans tout rejouer
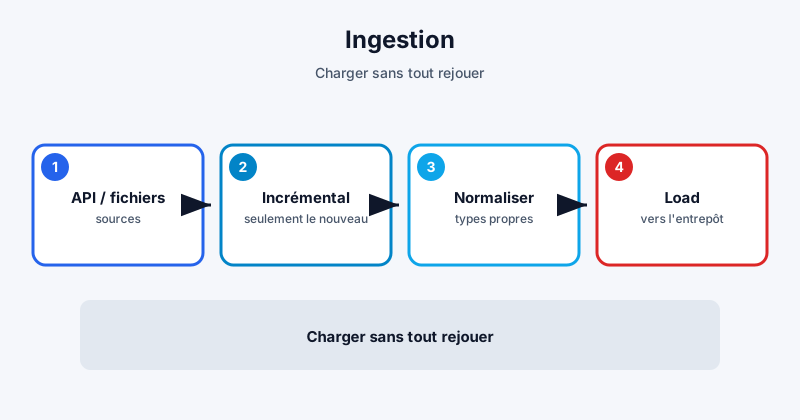
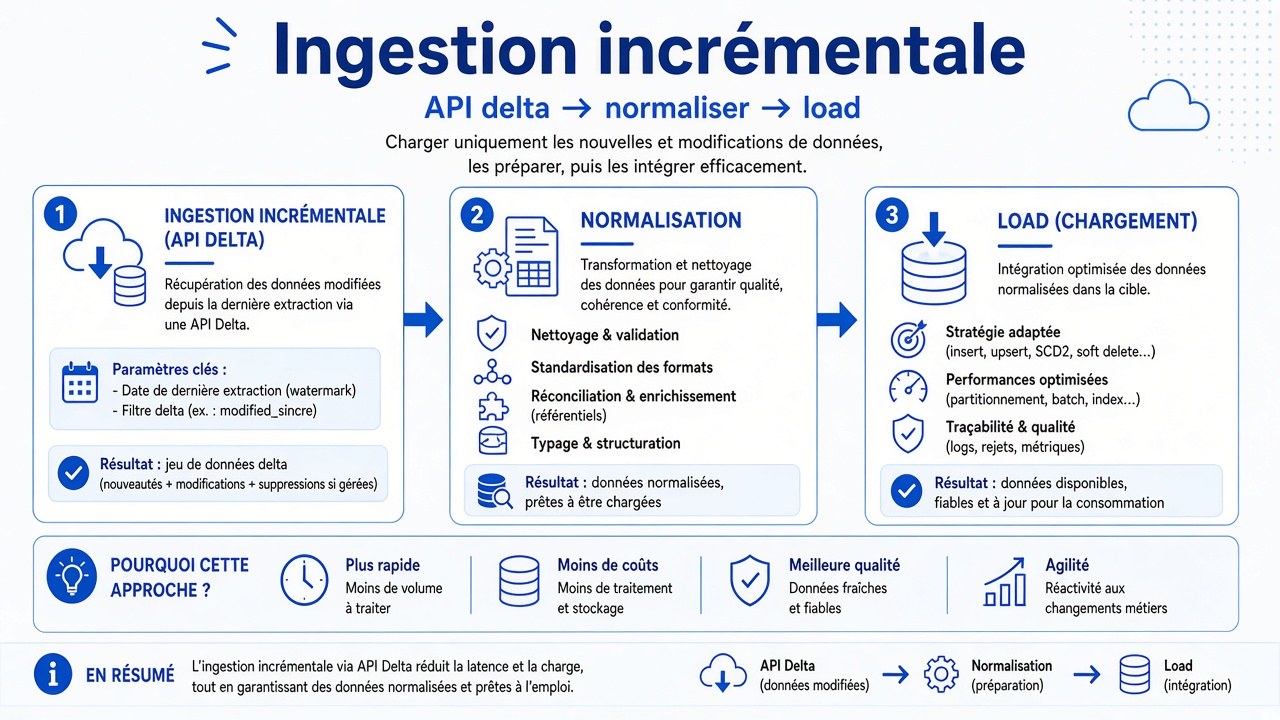
Tout recharger depuis 2019 chaque nuit, ça marche… jusqu'à ce que ça coûte cher et que ça dure trois heures. L'ingestion propre, c'est l'art de prendre le nouveau (ou le modifié) sans casser l'historique, et sans doubler les lignes si tu relances.
Cette série s'inspire du Data Engineering Zoomcamp. On reste concret : API, fichiers, curseurs, boutique. Pas de roman sur les « data lakes » magiques.
L'idée en une phrase
Ne prendre que le nouveau (ou le modifié), proprement.
Le problème, en boutique
Sophie a une boutique d'artisanat près de Metz. Son outil de caisse expose une API : liste des commandes. La première semaine, elle recharge tout chaque nuit. 2 000 lignes, ça passe. Six mois plus tard : 80 000 lignes, l'API rate, le job dépasse le créneau, le dashboard du matin est vide.
La solution n'est pas « plus de machines ». C'est l'incrémental : depuis hier 5 h, ou depuis le dernier updated_at, ou depuis le dernier id. Tu charges le delta. Tu le ranges. Tu notes où tu t'es arrêté.
Même logique pour un magasin à Nancy qui reçoit un CSV de stock chaque soir : tu ne réécrases pas cinq ans d'historique pour dix lignes changées.
Trois mots utiles (à coller au mur)
Incrémental
Tu ne repars pas de zéro. Tu avances avec un curseur : une date, un timestamp, un numéro de page, un id. Demain, tu reprends après ce curseur.
Idempotent
Relancer le même job ne double pas les lignes. Si tu as déjà la commande C-1042, tu la mets à jour ou tu l'ignores - tu ne la recopies pas une deuxième fois. Les retries de l'orchestrateur adorent ça.
Normaliser
Types stables, fuseaux clairs, noms de colonnes lisibles. 01/10/26 vs 2026-10-01 vs timestamp UTC : choisis une règle et tiens-toi-y. Une boutique en Lorraine qui mélange heure locale et UTC, c'est le panier moyen qui saute d'un jour.
Un flux simple (esprit)
- Lire la source (API, CSV, base métier).
- Filtrer depuis le curseur.
- Normaliser (types, dates, trim des chaînes).
- Dédupliquer sur une clé métier (id commande).
- Écrire dans le brut (raw).
- Sauver le nouveau curseur.
Si l'étape 5 réussit et l'étape 6 plante, tu dois pouvoir relancer sans catastrophe. D'où l'idempotence.
Exemple API commandes
L'API renvoie les commandes du jour, ou updated_since=.... Tu charges, tu dédupliques sur l'id commande, tu écris dans le brut. Demain, tu reprends où tu t'es arrêté.
Cas limites (ils arrivent) :
- une commande modifiée après coup (annulation, remboursement) → ton filtre doit voir les updates, pas seulement les créations ;
- l'API pagine → tu boucles jusqu'à la fin, sinon tu perds la page 3 ;
- l'API n'a pas de filtre date → full + merge sur clé, ou hash de ligne, mais documente le contrat. Ne laisse pas ça dans ta tête.
Fichiers vs API
Fichier du soir (export stock, export caisse) : souvent un full du jour. Tu ranges le fichier avec une date dans le nom (stock_2026-10-01.csv), tu charges, tu gardes le fichier. L'historique, c'est aussi les fichiers.
API : souvent mieux pour l'incrémental, mais plus de pièges (pagination, rate limit, auth). Un commerce à Thionville qui tire 50 000 appels / nuit va se faire taper sur les doigts. Batche, dors un peu entre les pages, respecte les quotas.
Ce que tu ranges dans le brut
Le brut, c'est le « tel quel, presque ». Tu peux ajouter des colonnes techniques : loaded_at, source_file, run_id. Tu ne calcules pas encore le panier moyen ici. Tu préserves. La magie métier vient plus tard (entrepôt, dbt).
Si tu « nettoies trop » dès l'ingestion, tu perds la trace de ce que la source a vraiment dit. Et le jour du bug, tu veux cette trace.
Erreurs classiques
-
Full reload par paresse
Ça va… jusqu'à ce que ça ne aille plus. -
Curseur avancé avant le load réussi
Tu « sautes » des données. Avance le curseur après l'écriture réussie. -
Pas de clé métier
Sans id stable, l'idempotence est un rêve. Demande-toi dès le jour 1 : « qu'est-ce qui identifie une commande ? » -
Ignorer les suppressions
Parfois une ligne disparaît côté source. Décide : soft delete, table des tombstones, ou full périodique. Mais décide.
Comment ça se branche sur la suite
L'ingestion remplit le raw de l'entrepôt (prochain article BigQuery). Ensuite dbt (ou du SQL) transforme vers staging / marts. L'orchestrateur lance le tout. Si l'ingestion est sale, tout le tuyau avale du sable.
En résumé
Ingestion propre = moins de surprises plus bas dans le tuyau.
Delta + clé + curseur sûr. Relancer ne doit pas faire peur.
Prochaine étape : ranger ça dans un entrepôt avec des couches claires.
Questions fréquentes (FAQ)
Et si l'API n'a pas de filtre date ?
Tu gères un cache / un hash / un full + merge - mais documente le contrat. Ne laisse pas le comportement « magique ».
Incrémental = temps réel ?
Non. Incrémental, c'est « seulement le nouveau », même une fois par nuit. Le streaming, c'est une autre histoire (fin de série).
Je charge où d'abord ?
Souvent fichiers / raw d'abord, puis entrepôt. L'important : séparer brut et prêt métier.
CSV local, ça compte ?
Oui. Beaucoup de boutiques commencent ainsi. Le jour où le volume grossit, tu changes la source, pas forcément toute la logique de curseur.
Idempotent, c'est obligatoire ?
Dès que tu as des retries, oui. Sinon chaque alerte suivie d'un relancement te fabrique des doublons.
Navigation dans la série
- Précédent : Orchestration
- Suivant : BigQuery