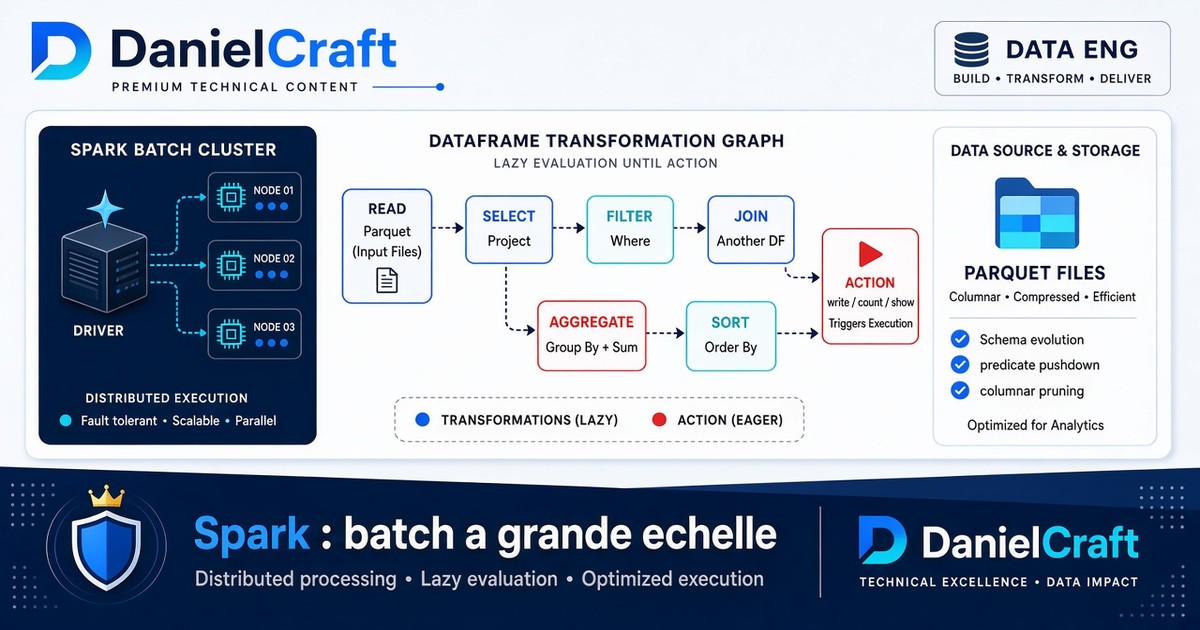
Spark : gros volumes en batch
Une seule machine suffit… jusqu'au jour où non. Spark sert à traiter de gros volumes en batch : fichiers lourds, historiques longs, transforms trop lents ailleurs. Ce n'est pas un badge de prestige. C'est un outil de volume.
Cette série s'inspire du Data Engineering Zoomcamp. On reste calme : DataFrame, actions, quand oui / quand non. Exemple boutique inclus.
L'idée en une phrase
Découper le calcul sur plusieurs workers, puis écrire le résultat.
Batch, rappel express
Batch = tu traites un tas de données déjà là (la nuit, l'heure). Pas événement par événement en direct. Pour beaucoup de commerces, le batch nocturne reste le bon réflexe. Kafka (article suivant) arrive seulement si tu as vraiment besoin du fil de l'eau.
Le problème que Spark attaque
Imagine une chaîne avec plusieurs boutiques en Lorraine : Metz, Nancy, Épinal. Tu archives des années de tickets de caisse en fichiers. Un jour, tu veux recalculer un historique de panier moyen par magasin / jour sur cinq ans. Ton laptop chauffe. Postgres local s'étouffe. Même un entrepôt peut souffrir si tu envoies un job mal pensé.
Spark (ou un service managé équivalent) découpe le travail : plusieurs machines (workers) traitent des morceaux, puis tu réécris un résultat propre (souvent Parquet / table).
Tu ne « magiques » pas le volume. Tu le parallélises.
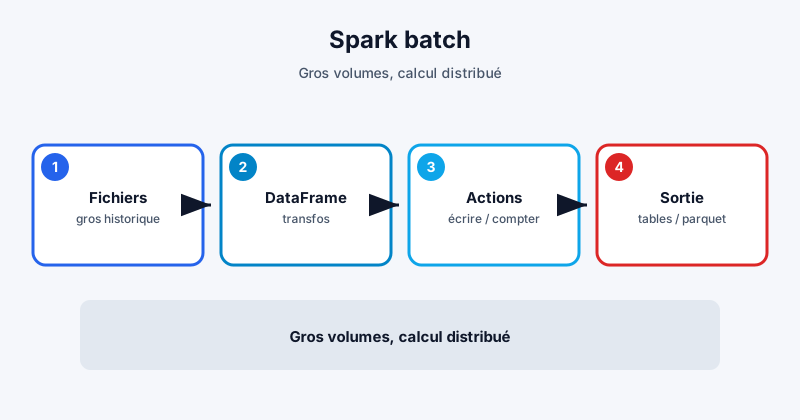
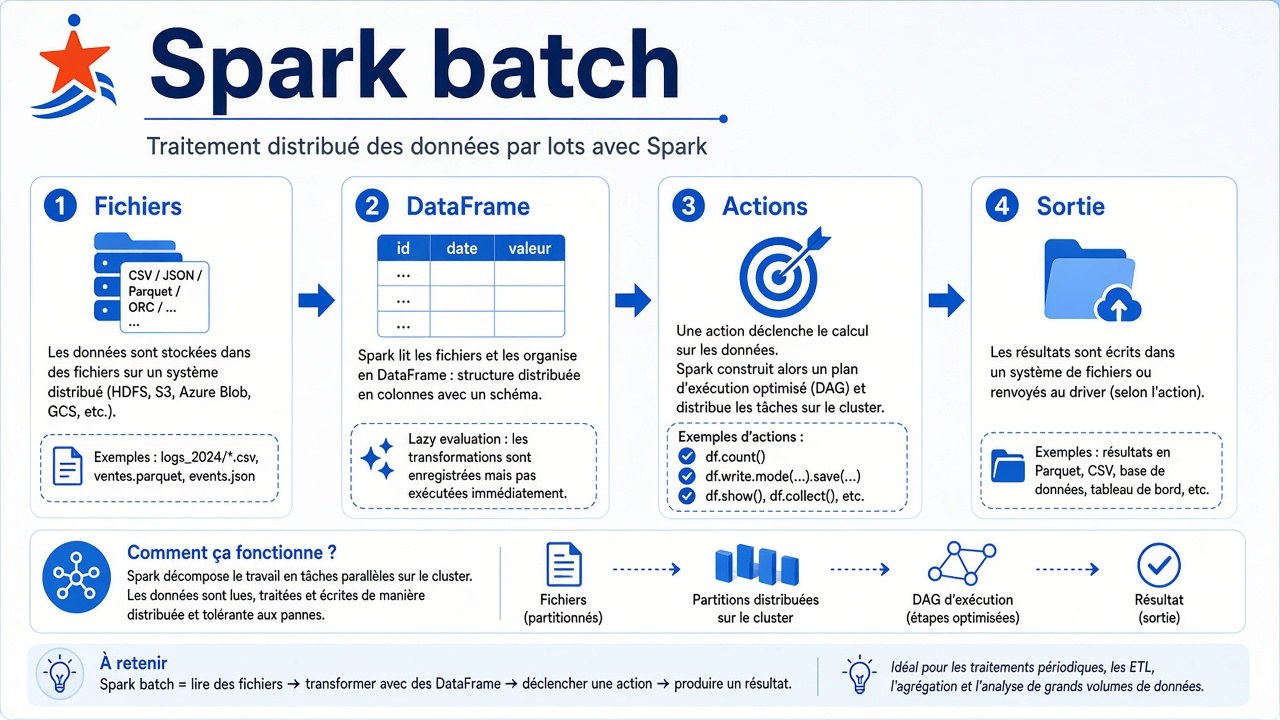
Fichiers → DataFrame → actions → sortie
Esprit simple :
- Tu lis des fichiers (ou une source) ;
- tu obtiens une structure type DataFrame (lignes / colonnes, comme une table) ;
- tu décris des transforms (filtre, jointure, agrégat) ;
- une action déclenche vraiment le calcul (écrire, compter…) ;
- tu sors le résultat vers stockage / entrepôt.
Tant que tu enchaînes des transforms « paresseux », rien de coûteux n'est forcément exécuté. L'action, c'est le moment où ça travaille pour de vrai. Utile à retenir pour ne pas relancer dix fois le même gros job sans le vouloir.
Quand tu en as besoin
- historiques lourds (années de tickets, logs) ;
- transforms trop lents en SQL simple sur une seule machine ;
- formats fichiers massifs (Parquet, gros CSV éclatés) ;
- besoin de retraiter tout un passé pour une nouvelle règle métier.
Exemple : la boutique change la définition du panier moyen (hors retours). Il faut recalculer trois ans. Spark (ou équivalent) peut digérer le retraitement batch.
Quand tu n'en as pas besoin
- 50 000 lignes bien gérées dans BigQuery / Postgres ;
- un cron + script qui finit en 2 minutes ;
- une seule boutique à Metz avec un export quotidien léger ;
- envie de mettre Spark sur le CV sans douleur volume.
Dans ces cas, dbt + entrepôt + orchestration suffisent largement. Ajouter Spark « pour faire pro », c'est ajouter de la complexité pour le plaisir. Le client du magasin s'en fiche : il veut le bon chiffre le matin.
Spark et dbt / entrepôt
Souvent complémentaires, pas ennemis :
- Spark (ou job distribué) pour préparer de gros fichiers / historiques ;
- chargement vers l'entrepôt ;
- dbt pour la couche analytique propre, tests, marts.
Parfois l'entrepôt digère tout seul. Mesure d'abord. N'introduis Spark que quand le chronomètre et le coût le demandent.
Erreurs classiques
-
Spark trop tôt
Tu passes plus de temps à configurer qu'à apprendre la data. -
Petit fichier, gros cluster
L'overhead mange le gain. Le parallélisme aime les volumes réels. -
Tout réécrire chaque nuit sans besoin
Même esprit que l'ingestion : incrémental quand c'est possible. -
Oublier le schéma
Colonnes qui changent de type au fil des fichiers = job qui casse à 4 h. Valide, documente.
Comment lire la suite
Kafka parle d'événements en continu. Avant d'y aller : sois à l'aise avec un pipeline batch fiable (ingestion → entrepôt → dbt). Beaucoup de besoins « on voudrait du temps réel » sont en fait « on voudrait le chiffre à 7 h ». Le batch suffit.
En résumé
Spark = outil de volume. Pas un badge de prestige. Utilise-le quand le besoin est réel.
Fichiers → transforms → action → sortie. Mesure avant de distribuer.
Prochaine étape : Kafka et le streaming - avec le rappel que le batch reste souvent le bon premier choix.
Questions fréquentes (FAQ)
Spark remplace dbt ?
Non. Souvent complémentaires selon la couche. dbt brille sur la transform SQL testée dans l'entrepôt.
Je dois installer un cluster chez moi ?
Pour apprendre, des modes locaux / labs existent. En prod, on passe souvent par un service managé. L'idée compte plus que l'usine le premier jour.
Pandas, c'est fini ?
Non. Pandas (ou équivalent) reste super pour petits / moyens volumes. Spark arrive quand ça ne rentre plus confortablement.
Parquet, c'est obligatoire ?
Non, mais c'est un format courant, efficace pour l'analytique. Mieux qu'un CSV géant pour rejouer souvent.
Une PME du Grand Est en a besoin ?
Parfois, si l'historique ou les fichiers explosent. Souvent, non au début. Commence simple, grossis avec la douleur réelle.