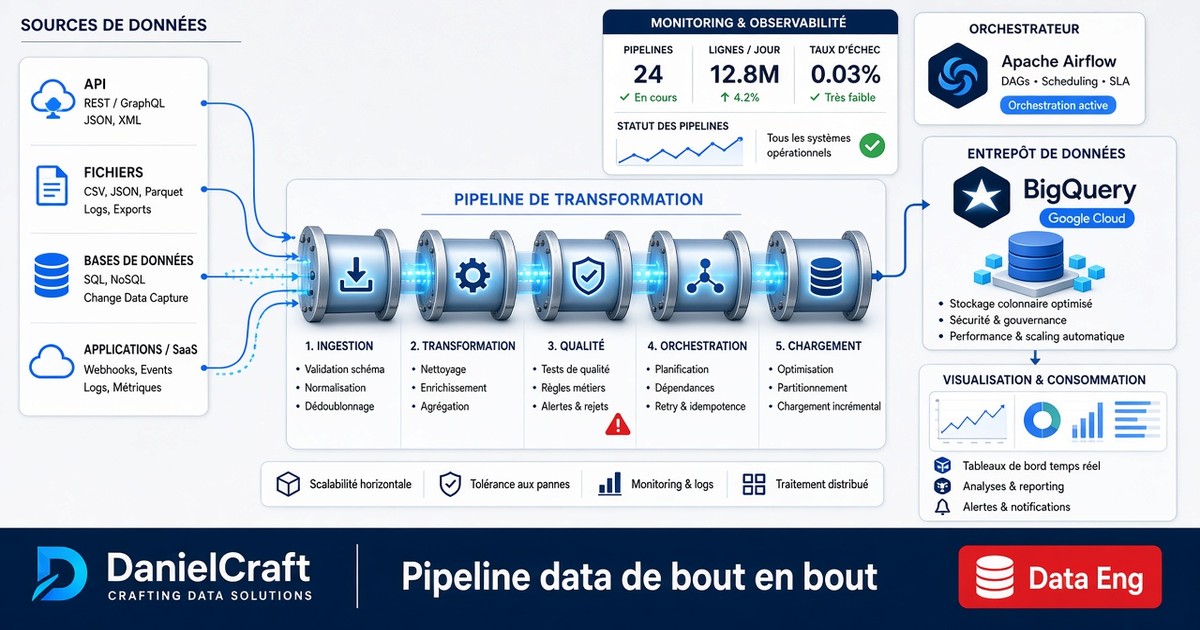
Data engineering : un pipeline de bout en bout
Tu entends « data engineer » partout. Souvent, on imagine quelqu'un qui fait des graphiques. En vrai, non. Le data engineer construit les tuyaux. Pas le tableau de bord final. Pas le modèle de prédiction. Les tuyaux qui amènent des données propres, à l'heure, au bon endroit.
Cette série s'inspire du Data Engineering Zoomcamp. Le texte est original, en français, et on vise la clarté d'abord. Tu n'as pas besoin d'être déjà « data » pour suivre.
L'idée en une phrase
Faire arriver les données au bon endroit, propres, à l'heure - pour que les autres puissent les utiliser.
Comme un livreur fiable : il s'assure que les bons colis arrivent, sans casse, sans doublon, sans retard silencieux.
C'est quoi un pipeline, concrètement ?
Un pipeline, c'est une chaîne d'étapes automatisées. Chaque étape prend une entrée, fait un travail, passe le résultat à la suivante. Personne n'exporte un Excel à la main chaque lundi (enfin, on arrête de le faire).
Imagine une boutique à Metz. Tu veux le panier moyen par jour, et l'effet d'une campagne promo. Les commandes sont dans une base. Les campagnes sont dans une autre appli.
Sans pipeline : - tu exportes les commandes ; - tu colles les campagnes dans un tableur ; - tu croises « à peu près » ; - le chiffre change selon qui a fait le fichier.
Avec pipeline : - chaque nuit (ou chaque heure), un job lit les sources ; - un autre nettoie et joint ; - le résultat atterrit dans un entrepôt ; - le dashboard lit des tables stables.
Le métier voit un chiffre. Toi, tu as construit le chemin jusqu'à ce chiffre.
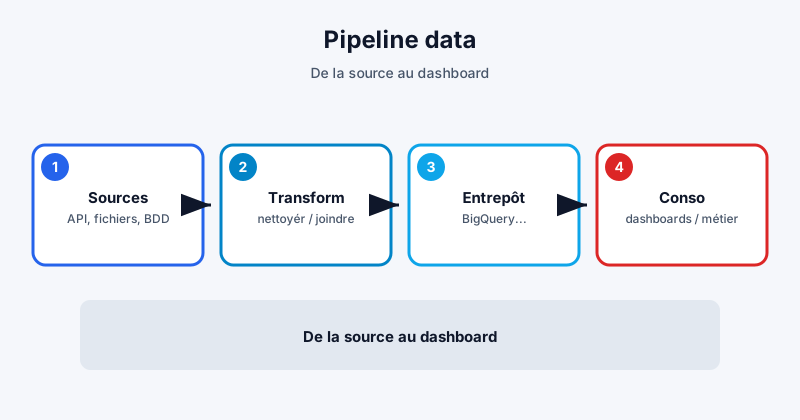
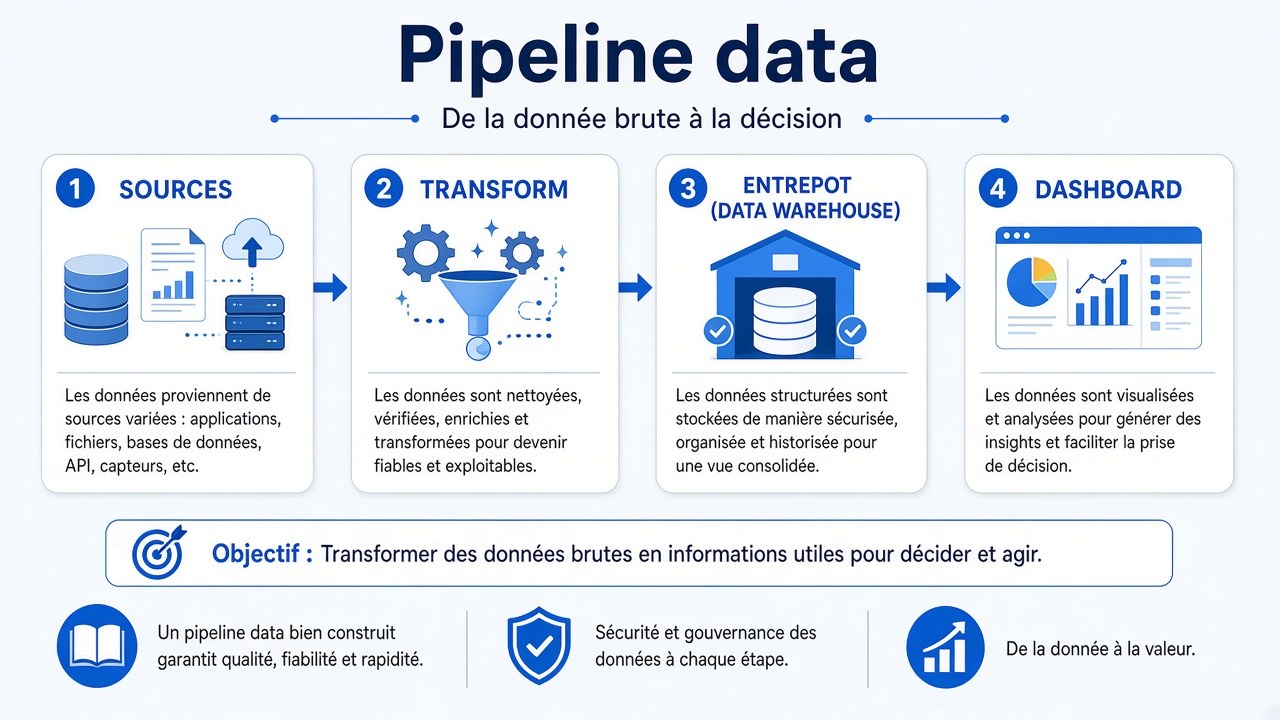
Les 4 zones (à retenir)
1. Les sources
Là où les données naissent : API, fichiers CSV, base métier, caisse, formulaire. Chez une boutique lorraine, ça peut être : commandes en ligne, tickets de caisse, avis Google, stock.
2. La transformation
On nettoie, on joint, on agrège. On corrige les fuseaux, les noms de colonnes bizarres, les doublons. On passe du « brut un peu sale » au « prêt à lire ».
3. L'entrepôt
L'endroit où on stocke pour analyser. Pas forcément la base de prod (celle qui sert la boutique le jour J). Un entrepôt type BigQuery, Snowflake, ou même un Postgres dédié au départ.
4. La consommation
Dashboards, requêtes métier, exports, parfois un modèle ML plus tard. C'est la vitrine. Si les tuyaux sont pourris, la vitrine ment.
Un pipeline de bout en bout relie les quatre. Le data engineer s'occupe surtout des trois premières, et s'assure que la quatrième a de quoi manger.
ETL vs ELT (version simple)
Deux familles, même but.
- ETL : Extract, Transform, Load. Tu transformes avant de charger dans l'entrepôt.
- ELT : Extract, Load, Transform. Tu charges d'abord le brut, tu transformes dans l'entrepôt (souvent avec dbt et du SQL).
Tu n'as pas à choisir une religion le premier jour. Retiens surtout ça : sépare le brut du prêt à analyser. Le brut, tu le gardes. Le prêt métier, tu le reconstruis. Si tu mélanges tout dans une seule table « magique », tu te mords les doigts six mois plus tard.
Exemple boutique (Metz / Lorraine)
Sophie tient une boutique d'artisanat près de Metz. Elle veut répondre à trois questions simples :
- Combien de commandes hier ?
- Quel panier moyen sur la semaine ?
- Est-ce que la promo « mirabelle » a vraiment bougé les ventes ?
Sans data eng, elle ouvre trois outils, exporte, compare à l'œil. Avec un petit pipeline : extract des commandes + extract des codes promo → tables propres → un graphique clair le matin. Elle décide plus vite. Pas besoin d'un data lake géant. Un flux fiable suffit.
« Production-ready », sans blabla
Ça veut dire trois choses concrètes :
- Planifiable : ça tourne tout seul (nuit, heure, événement).
- Observable : tu sais si ça a marché, combien de lignes, combien de temps.
- Rejouable : si ça casse, tu relances sans doubler toutes les commandes.
Un script « ça marche sur mon PC » n'est pas un pipeline. Un pipeline, c'est un script (ou plusieurs) + un calendrier + des garde-fous.
Ce que tu vas apprendre dans la série
On avance brique par brique, dans cet ordre :
- Vue d'ensemble (cet article).
- Lab local (Docker) et infra cloud rejouable (Terraform).
- Orchestration (planifier, retenter, alerter).
- Ingestion (charger sans tout rejouer).
- Entrepôt (BigQuery et couches).
- Transformation analytique (dbt).
- Gros volumes en batch (Spark).
- Streaming (Kafka) - seulement si le besoin est réel.
À la fin, tu as une carte mentale. Pas un diplôme. Une carte pour savoir où placer chaque outil.
Lien avec les autres séries
Le data engineering, c'est le terrain. Les modèles de langage et les agents, c'est souvent la couche au-dessus : ils consomment des infos propres, ou ils appellent des outils branchés sur tes systèmes.
Si tu veux aussi comprendre les LLM et les agents (ton simple, même esprit) :
- série LLM : /blog/series/llm-transformers-serie.html
- série Agents : /blog/series/hf-agents-serie.html
Les agents ont besoin de faits. Les tuyaux livrent les faits.
En résumé
Data eng = fiabilité du flux. Le dashboard n'est que la vitrine.
Commence petit : une source, une table propre, un schedule. Puis tu allonges le tuyau.
Prochaine étape : un lab local avec Docker, et une infra cloud décrite en code avec Terraform.
Questions fréquentes (FAQ)
C'est la même chose que data analyst ?
Non. L'analyste consomme et explique. L'engineer livre des tuyaux fiables. Parfois la même personne fait les deux en PME - les rôles restent différents.
Faut-il du cloud dès le jour 1 ?
Non. Tu peux apprendre avec Docker en local. Le cloud vient quand tu veux stocker / partager pour de vrai.
Excel, c'est interdit ?
Non. Excel est un outil de conso. Le problème, c'est quand Excel est le pipeline.
Par où commencer concrètement ?
Une source (API ou CSV), une table propre, un job planifié. Un chiffre métier que tout le monde comprend (ex. commandes du jour).
Ça sert à une petite boutique ?
Oui, dès que tu perds du temps à recoller des exports.
Navigation dans la série
- Suivant : Docker et Terraform